Jev быстро стала одной из самых обсуждаемых моделей в сфере искусственного интеллекта. Это мощная модель классификации, которая работает быстро и невероятно дешево.
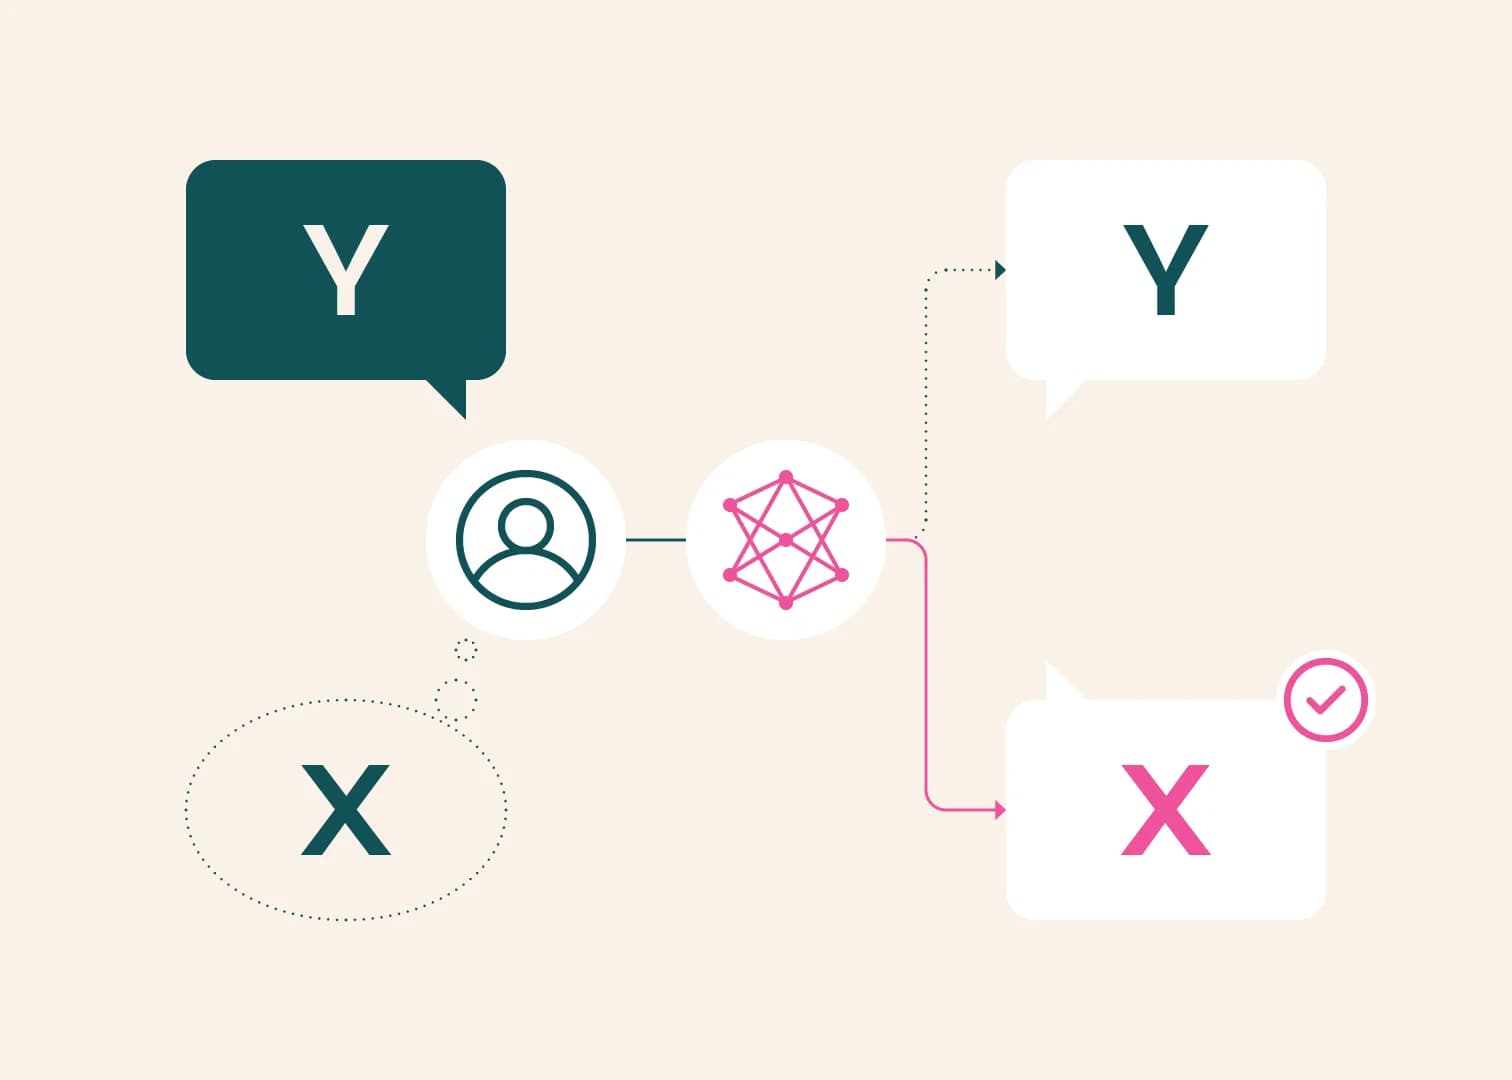
Дайте Jev набор данных и предопределенные вопросы, и она мгновенно выдаст результат в виде оценки, булевого значения или ответа с вариантами выбора.
У этого типа моделей классификации множество реальных сценариев применения: например, оценка интернет-магазином автоматических возвратов от клиентов, категоризация научных работ по машинному обучению или даже определение тональности текста.
Сегодня мы собираемся дообучить собственную модель классификации в стиле Jev, которая принимает состояние и возвращает ответ. Наша цель — создать модель, способную быстро и эффективно отвечать на такие вопросы, как:
В этой статье мы рассмотрим, как дообучить и развернуть модель классификации, способную отвечать на подобные вопросы. К тому моменту, как мы закончим, у вас будет собственная развернутая модель с эндпоинтом API, которую легко интегрировать в любое программное обеспечение.
Давайте начнем с настройки вашего компьютера и установки всего необходимого для обучения модели.
Если вы предпочитаете сразу перейти к использованию классификатора и не тратить время на самостоятельное обучение модели, обратите внимание на together/Tev1-4B-experimental на бессерверной платформе Together.
Начало работы
Первое, что нам нужно сделать — это склонировать репозиторий GitHub tev1.
После клонирования репозитория необходимо установить необходимые зависимости с помощью команды:
Заключительный шаг настройки — создание файла .env, в котором будут храниться необходимые переменные окружения.
Скопируйте .env.example:
Отредактируйте новый файл .env и добавьте ваш TOGETHER_API_KEY. Пока что вам не нужно добавлять JEV_MODEL. Оставьте это поле пустым.
Вот и все. Теперь мы готовы к дообучению нашей модели.
Дообучение модели классификации
Следующий шаг заключается в том, чтобы взять существующую языковую модель и превратить ее в модель, специализирующуюся на классификации. Для этого нам потребуется создать задачу дообучения, используя базовую модель и набор существующих датасетов.
В качестве базовой модели мы будем использовать Qwen3.5 4B, а в качестве датасетов — несколько наборов данных, размещенных на Hugging Face.
Выбор датасетов
Мы возьмем выборку из 38 000 вопросов из различных датасетов, каждый из которых специализируется на определенном типе классификации.
Вот эти датасеты и количество примеров, которые мы будем использовать:
Мы используем всего 38 340 примеров, чтобы снизить затраты на дообучение. Обучение на датасете такого размера обойдется примерно в $17.0, в то время как более крупные наборы данных стоят дороже и требуют больше времени для обучения.
Нормализация данных
Теперь, когда мы выбрали шесть источников данных, нам нужно сделать выборку ограниченного количества вопросов из них, а также нормализовать эти вопросы, чтобы они все имели одинаковый формат.
Репозиторий содержит ряд скриптов на Python, которые автоматизируют этот процесс.
Сначала скачайте датасеты:
Затем сделайте выборку и нормализуйте вопросы, которые мы будем использовать для обучения:
При выполнении этих команд вы должны увидеть вывод без каких-либо ошибок.
Теперь, когда у нас есть обучающие датасеты, мы готовы перейти к следующему шагу и дообучить модель классификации.
Обучение модели
Мы можем запустить задачу дообучения с помощью сервиса Fine-tuning от Together AI.
Существует скрипт на Python, который поможет автоматизировать этот процесс. Запустите его с помощью команды:
Этот скрипт выполняет ряд шагов, необходимых для обучения модели. Сначала он выгружает обучающие данные на Together, а затем запускает задачу дообучения с использованием датасета и подходящих параметров.
После запуска задачи дообучения скрипт выведет идентификатор задачи обучения (job ID).
Вы можете проверить статус обучения с помощью интерфейса командной строки Together CLI:
Вы также можете проверить статус задачи обучения с помощью панели управления Fine-tuning на Together AI.
Задача обучения займет около 25 минут, после чего у нас будет модель, готовая к классификации.
Развертывание модели
Прежде чем мы сможем развернуть нашу модель, нам нужно узнать ее имя из задачи дообучения. Выпустите следующую команду:
Эта команда выведет model_output_name модели. Мы будем использовать это имя для развертывания модели на выделенном эндпоинте в Together AI.
Выделенные эндпоинты отвечают за предоставление доступа к дообученной модели через HTTP-сервер, чтобы мы могли отправлять к ней запросы.
Выполнение этой команды вернет информацию о вашем новом эндпоинте:
После создания вы увидите имя эндпоинта в выводе. Вы также можете найти дополнительную информацию об эндпоинте на панели управления выделенными эндпоинтами (Dedicated endpoints) на Together AI.
Укажите имя эндпоинта в вашем файле .env в качестве JEV_MODEL. Например, если ваш эндпоинт называется account_855c/Qwen3.5-4B-jev-efde5bd5-068f756b, то в вашем файле .env должно быть указано:
Вот и все. Ваша модель теперь развернута на Together AI и готова отвечать на любые вопросы классификации.
В следующем разделе мы научимся делать запросы к нашей модели.
Запросы к модели
Репозиторий кода содержит ряд тестовых примеров для проверки правильности работы модели. Давайте используем нашу модель классификации, чтобы определить намерение вопроса клиента по поводу его подписки:
Сообщение клиента: Здравствуйте, я проверил выписку, и ваша компания списала с моей карты средства за октябрьскую подписку дважды. Обе суммы составляют по $19,99 за тот же день. Я не менял свой тарифный план.
Поскольку наша модель была дообучена на входных и выходных данных в формате JSON, нам нужно отформатировать этот вопрос и возможные варианты ответа с помощью структуры данных JSON следующим образом:
И мы можем отправить эту структуру данных нашей модели для классификации с помощью следующей команды:
Файл examples/charge-dispute.json содержит наш пример JSON из примера выше, а decide.py — это скрипт Python, который отправляет его нашей дообученной модели.
Как только мы отправим запрос, мы сразу увидим ответ модели:
Это именно то, что мы хотели увидеть. Это не только правильный ответ, но и правильный формат вывода, которому модель научилась на наших обучающих данных.
В папке examples/ есть еще несколько примеров. Эти примеры включают вопросы, связанные с намерениями, пониманием «да/нет», проверкой булевых правил и анализом тональности. Попробуйте изменить их и запустить против вашей развернутой модели.
Примечание: Наш пример скрипта автоматически передает системный промпт и настройки инференса. При вызове API напрямую или при использовании Chat Playground явно установите temperature=0, max_tokens=8 и chat_template_kwargs={"enable_thinking": false}. Эти значения по умолчанию не добавляются автоматически текущим публичным эндпоинтом.
Используйте следующий системный промпт:
Заключение
После завершения экспериментов с новой моделью вы можете отключить выделенный эндпоинт с помощью команды:
Чтобы использовать модель снова позже, перезапустите выделенный эндпоинт или воспользуйтесь хостинговой версией together/Tev1-4B-experimental на нашей бессерверной платформе.
Потратив около 17 долларов на обучение и двадцать пять минут ожидания, вы получаете собственную дообученную модель классификации, развернутую за HTTP-эндпоинтом, которая отвечает в формате, ожидаемом вашим программным обеспечением.