«Открытость» представляет собой одно из важнейших обещаний в корпоративных технологиях: свободу выбирать правильные инструменты, адаптироваться по мере изменения потребностей и внедрять инновации без перестройки фундамента данных. Открытые форматы, API и проекты с открытым исходным кодом помогают продвигать это видение. Но подлинная открытость в конечном итоге измеряется тем, что могут делать клиенты — насколько легко они могут переходить между технологиями, объединять платформы и развивать свою архитектуру с течением времени.
На саммите dbt Summit Джордж Фрейзер (George Fraser), генеральный директор Fivetran + dbt Labs, Рассел Спитцер (Russell Spitzer), главный инженер-программист в Snowflake, Дипти Боркар (Dipti Borkar), вице-президент Microsoft IQ и Microsoft One Lake в Microsoft, и Джордан Тигани (Jordan Tigani), соучредитель и генеральный директор MotherDuck, обсудили, что требуется для выполнения этого обещания. В ходе беседы был затронут ключевой вопрос для следующего поколения архитектуры корпоративных данных: что должно оставаться переносимым, чтобы организации могли в полной мере ощутить ценность открытой экосистемы?
Ответ выходит далеко за рамки форматов файлов. Организациям необходимо контролировать, где хранятся их данные, выбирать подходящий вычислительный движок для каждой рабочей нагрузки, применять согласованные политики безопасности, сохранять бизнес-смысл в различных инструментах и заменять компоненты без перестройки окружающей их системы. Если хотя бы один из этих уровней становится проприетарным, привязка к вендору просто перемещается куда-то в другое место.
[CTA_MODULE]
Открытые форматы — это начало, а не финишная прямая
Форматы открытых таблиц, такие как Apache Iceberg, изменили архитектуру корпоративных данных. Разделив хранение данных и движок, используемый для их обработки, они позволяют нескольким платформам работать с одними и теми же базовыми таблицами. Это дает организациям больше контроля над своими данными и больше свободы в развитии окружающих их инструментов.
Но открытой таблицы недостаточно, если каждый движок по-своему интерпретирует доступ. Управление (говернанс) может стать следующей точкой привязки: политики определяются в одном каталоге, реализуются по-разному на разных платформах и создаются заново каждый раз, когда в архитектуру добавляется новый движок.
Участники дискуссии отметили недавнюю работу над ограничениями на чтение в протоколе Iceberg REST как важный шаг вперед. Цель состоит в том, чтобы каталог возвращал не только информацию о таблице, но и правила, применимые к конкретному пользователю, запрашивающему ее. Вместо того чтобы переопределять средства контроля доступа для каждого движка по отдельности, организации смогут поддерживать единое определение политики и переносить его в совместимую среду. Как пояснил Спитцер из Snowflake: «В ближайшем будущем у вас будет одно определение ваших политик, одна точка доступа, через которую вы сможете обращаться к своему каталогу и одновременно получать всю эту информацию в свой движок».
Это различие имеет решающее значение, потому что гибкость без последовательного управления не является жизнеспособной корпоративной архитектурой. Специалисты по работе с данными не должны выбирать между открытостью и контролем. Как выразилась Боркар из Microsoft: «Клиенты заплатили достаточно налога на привязку к вендору». Перенос данных в открытый формат только для того, чтобы запереть их модель безопасности в другом проприетарном слое, приведет к воспроизведению той же проблемы под другим названием.
Таким образом, подлинная открытость требует, чтобы политики перемещались вместе с данными. Формат, каталог, движки и модель безопасности должны работать согласованно, чтобы добавление новой возможности вычислений не превращалось в новый проект по управлению.
«Клиенты уже заплатили достаточно налога на привязку, как мы это называем. Сейчас мы перешли к открытым форматам, и это здорово… мы должны убедиться, что они снова не окажутся привязаны к вендору». — Дипти Боркар (Dipti Borkar), вице-президент Microsoft IQ и Microsoft One Lake в Microsoft
Лучший движок должен побеждать в каждой рабочей нагрузке
Как только хранилище и управление становятся совместимыми, вычисления могут превратиться в конкурентный слой, а не в пожизненные обязательства.
Участники дискуссии привели практический пример. dbt Lake Compute, созданный на базе DuckDB, предназначен для интерактивных рабочих нагрузок трансформации. MotherDuck также построена на DuckDB, но фокусируется на интерактивном анализе с низким временем отклика, когда пользователь ждет результат. Эти движки могут делать различный архитектурный выбор, поскольку служат для разных целей. Когда данные хранятся в открытом формате, клиентам не нужно выбирать один движок для всех рабочих нагрузок.
В этом заключается более глубокое обещание разделения хранения и вычислений. Как пояснила Боркар из Microsoft: «Принцип OneLake заключается в том, что он открыт и унифицирован, и нам нужно убедиться, что с ним работает Fabric, работает Snowflake, работает Databricks. Каждый должен иметь доступ к одним и тем же данным. Это действительно должно быть открыто». Имея такой общий фундамент данных, команда может выбрать один движок для масштабных трансформаций, другой для интерактивного анализа, а третий — для ИИ-агентов. Подытоживая слова Тигани из MotherDuck: «Пусть победит лучший движок».
«И это, я думаю, показывает всю мощь таких открытых архитектур: если ваши данные находятся в Iceberg, Delta, Duck Lake, вы можете использовать любой нужный вам движок. Вы можете использовать лучший движок для трансформации, лучший движок для низкой задержки, лучший движок для агентов, и пусть победит сильнейший». — Джордан Тигани (Jordan Tigani), соучредитель и генеральный директор MotherDuck
Эта модель также меняет то, как вендоры выстраивают долгосрочные отношения с клиентами. В закрытой архитектуре удержание может частично зависеть от стоимости и сложности ухода. В открытой вендоры должны продолжать заслуживать право выполнять рабочие нагрузки за счет производительности, экономики, удобства использования и инноваций. Спитцер из Snowflake выразил этот принцип напрямую: «Мы должны держать все двери открытыми и доказывать ценностью продукта, что мы заслуживаем деньги клиентов».
Инфраструктура открытых данных не уничтожает платформы или конкуренцию. Она делает конкуренцию более здоровой. Клиенты получают свободу использовать лучший инструмент для конкретной задачи, в то время как у вендоров появляется более веский стимул продолжать улучшать свои продукты.
Переход не произойдет за одну ночь. Как отметил Фрейзер, многие предприятия до сих пор мигрируют с хранилищ данных, существовавших десятилетиями. Самое важное соперничество происходит не только между новейшими облачными платформами. Это борьба между архитектурами, ориентированными на долгосрочную зависимость, и архитектурами, ориентированными на выбор клиента.
Бизнес-смысл — следующая проблема переносимости
Обеспечение переносимости таблиц решает лишь часть проблемы — особенно по мере того, как искусственный интеллект становится основным потребителем корпоративных данных. Агенту нужен не просто доступ к строкам и столбцам. Ему необходимо понимать, что «выручка», «клиент» или «активная учетная запись» означают в рамках конкретного бизнеса.
Это делает семантический слой важнейшей частью инфраструктуры открытых данных. Фрейзер заявил, что по мере совершенствования моделей семантическая модель все больше выглядит как необходимый и потенциально достаточный фундамент для подключения ИИ к корпоративным данным. Опыт Fivetran показал, что добавление сложности не всегда улучшает результат. Зачастую четкая модель бизнес-сущностей, метрик и связей дает агенту всё необходимое для эффективного рассуждения.
Другие участники дискуссии рассматривали семантическую модель скорее как отправную точку, а не как окончательный ответ. Для некоторых предметных областей могут потребоваться более богатые онтологии и графы. Что еще важнее, командам необходимы оценки, которые проверяют, действительно ли агент использует доступный контекст и возвращает правильный результат. Если финансовый директор запрашивает данные о выручке за прошлый квартал, на этот вопрос есть один правильный ответ. Сложность контекстной системы имеет меньшее значение, если агент игнорирует ее или применяет некорректно.
Это указывает на новую ответственность для команд по работе с данными: поддержка оценок для вопросов на естественном языке может стать столь же важной, сколь и поддержка тестов для пайплайнов и трансформаций. Надежная диалоговая аналитика потребует от команд определять не только бизнес-смысл, но и то, как они проверяют, что агент его понял.
Семантическая переносимость также имеет значение. У предприятий уже есть годы бизнес-логики, закодированной в dbt, Looker, Power BI и других системах. Им не следует отказываться от этой работы ради внедрения нового интерфейса ИИ. Fivetran Context Layer создан для подключения к существующим семантическим моделям и публикации этого контекста для агентов. Тем временем Apache Ossie работает над независимым от вендоров форматом обмена для метрик, измерений и их взаимосвязей.
Эта амбициозная цель повторяет то, что Iceberg сделал для таблиц: сделать бизнес-смысл переносимым между платформами без потери его определения. Если индустрия преуспеет, организации смогут менять аналитику, BI или инструменты ИИ без необходимости каждый раз переводить бизнес на новый язык с нуля.
Открытая инфраструктура побеждает, когда ее принятие становится незаметным
Стандарты имеют значение только тогда, когда клиенты могут использовать их, не становясь экспертами в лежащих в их основе механизмах.
Именно поэтому последняя задача — это внедрение. Многие организации уже имеют работающие стеки данных, построенные вокруг проприетарных таблиц, жестко связанных вычислений или давно устоявшихся семантических моделей. Концепция, требующая заменить всё сразу, останется уделом лишь ранних последователей.
Фрейзер охарактеризовал роль Fivetran как облегчение перехода для таких существующих сред. По мере того как такие платформы, как Snowflake и Microsoft, добавляют более глубокую совместимость с Iceberg, Fivetran помогает клиентам внедрять открытые таблицы под их текущий стек данных, сохраняя при этом созданные поверх них рабочие процессы. Его заявленная цель была поразительно простой: сделать изменения настолько простыми, чтобы клиенты едва заметили внедрение Iceberg.
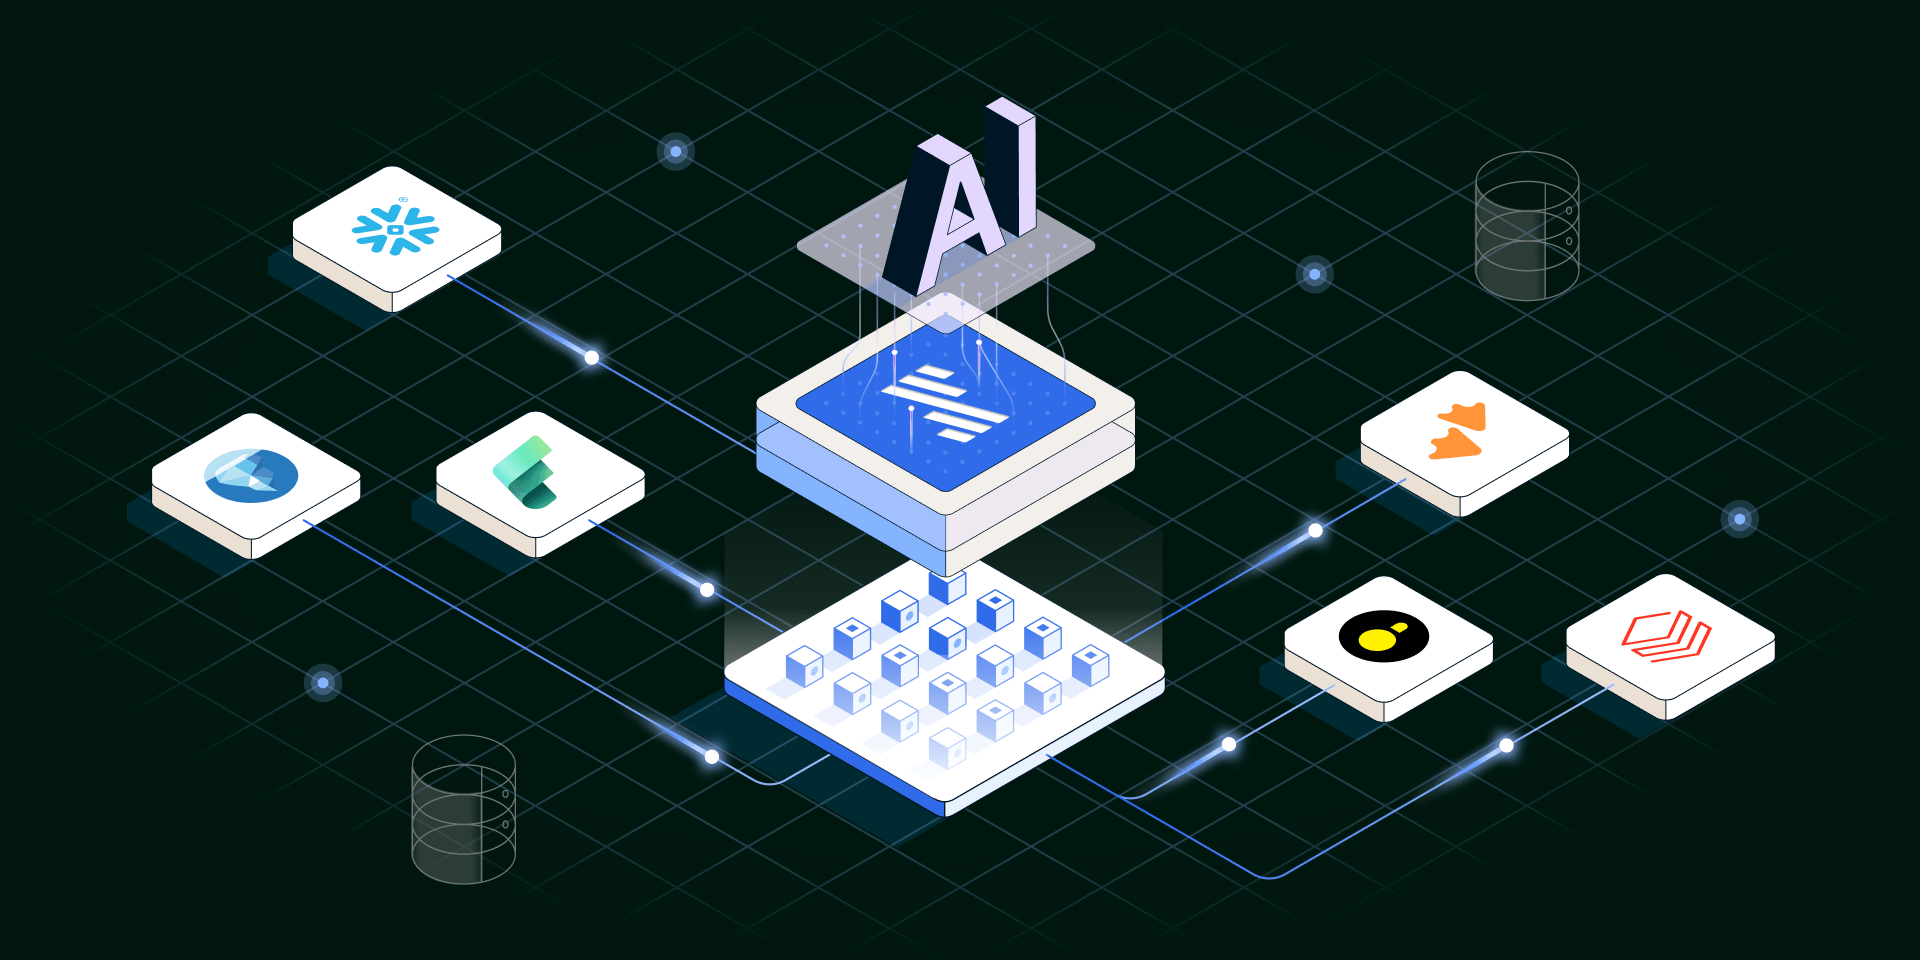
Именно так выглядит зрелая открытая инфраструктура данных (Open Data Infrastructure). Данные поступают в форматах, контролируемых клиентом, вычислительные движки сопоставляются с каждой рабочей нагрузкой, управление остается единообразным для разных движков, а семантические определения перемещаются между инструментами. Fivetran надежно доставляет данные в эту основу, в то время как dbt трансформирует их и сохраняет бизнес-логику, необходимую людям и агентам.
Ценность такой открытости носит практический, а не идеологический характер. Она сохраняет стратегическую гибкость, снижает стоимость внедрения более совершенных технологий, защищает существующие инвестиции в данные и семантическую работу, а также снижает риск того, что сегодняшнее решение в области ИИ превратится в завтрашний проект миграции.
Организации, лучше всего подготовленные к следующему поколению аналитики и ИИ, будут не теми, кто предсказывает каждую победившую технологию. Это будут те, кто строит архитектуру, способную изменяться при смене победителей.
[CTA_MODULE]