Эффективный CI/CD для команд, ориентированных на DevOps
Инструменты
Когда CI/CD-пайплайн дает сбой, его дашборд обычно может подсказать, что именно пошло не так. Инструменты наблюдаемости пайплайнов должны помочь разобраться в причинах: будь то нестабильный тест (flaky test), перегруженный агент сборки или проблема в другом месте процесса доставки.
Это становится сложнее по мере усложнения пайплайнов. Пайплайн задействует множество разрозненных систем: контроль версий, агенты сборки, контейнеры, тестовые фреймворки, репозитории артефактов, сканеры безопасности и инструменты развертывания. Каждая из них генерирует собственные данные, и собрать их воедино во время расследования непросто.
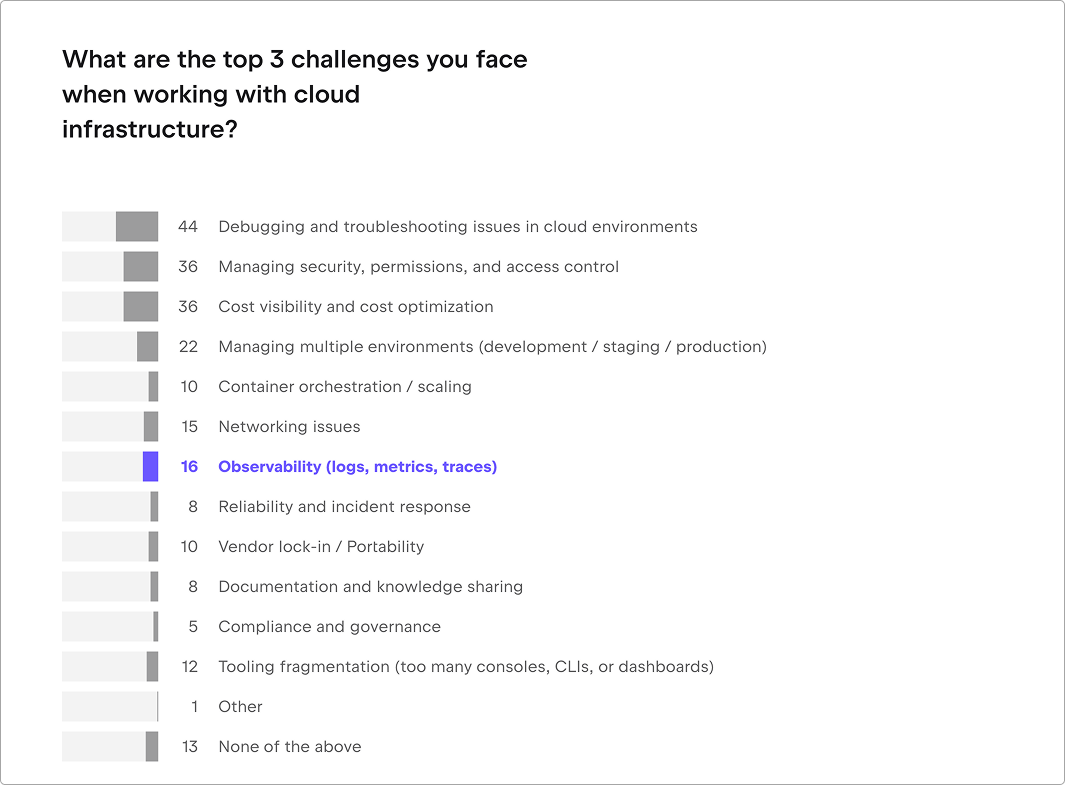
Отчет о состоянии экосистемы разработчиков JetBrains за 2026 год показывает, насколько распространены эти проблемы. Когда мы спросили 20 416 респондентов об их трех главных трудностях при работе с облачной инфраструктурой, 44% выбрали отладку и устранение неполадок в облачных средах.
Безопасность и контроль доступа выбрали 36%, так же как и видимость затрат и их оптимизацию. Наблюдаемость отметили 16%, а 12% указали на наличие слишком большого количества отдельных инструментов, консолей или дашбордов.
В этой статье объясняется, что такое наблюдаемость CI/CD-пайплайнов, какие метрики стоит отслеживать и чем отличаются самые популярные инструменты наблюдаемости. В ней также приводится структура для выбора подходящих инструментов наблюдаемости CI/CD для вашей команды.
Что такое наблюдаемость CI/CD-пайплайнов?
Наблюдаемость CI/CD-пайплайнов — это способность понимать состояние и поведение пайплайна доставки на основе производимых им данных, включая результаты сборки, метрики, логи, события и трейсы.
На практике наблюдаемый пайплайн должен помогать отвечать на такие вопросы, как:
- Почему сборки занимают больше времени, чем в прошлом месяце?
- Почему один пул агентов дает сбой чаще, чем другой?
- На каком этапе пайплайна появилась регрессия?
- Вызвано ли падение изменением в коде или что-то изменилось в среде сборки?
Мониторинг и наблюдаемость тесно связаны, но они не тождественны. Мониторинг пайплайна отслеживает известные условия. вы определяете метрику или событие, отображаете их на дашборде и, возможно, настраиваете оповещение при превышении порога.
Наблюдаемость помогает, когда причина проблемы не очевидна сразу. Она предоставляет достаточно взаимосвязанных данных для исследования неожиданных сбоев без необходимости предварительно добавлять новое отслеживание и ждать повторения проблемы.
Например, мониторинг может показать, что длительность сборки внезапно увеличилась. Наблюдаемость помогает проследить это увеличение до конкретного пайплайна, этапа, агента сборки, коммита, теста или проблемы с инфраструктурой.
Что следует отслеживать в CI/CD-пайплайне?
Наблюдаемость пайплайна охватывает как работу, выполняемую самим пайплайном, так и платформу, на которой он запущен.
На уровне пайплайна эти метрики делятся на две группы: в первую входят время ожидания в очереди, общая длительность и длительность этапов, которые показывают, где разработчики вынуждены ждать. Во вторую группу входят показатели успешности, повторные попытки, нестабильные тесты и производительность кэша, которые показывают, где сам пайплайн становится менее надежным.
На уровне платформы командам необходима видимость агентов или раннеров, потребления ЦП и памяти, дисковой и сетевой активности, работоспособности сервера и доступности внешних зависимостей. Этот контекст помогает отличить проблему в коде от проблемы в инфраструктуре.
Наиболее полезными являются метрики, привязанные к конкретному расследованию.
Перцентили обычно более информативны, чем средние значения для метрик длительности и времени ожидания в очереди. Стабильное среднее значение может скрывать плохой опыт для наименее эффективных 5% или 10% сборок.
Изучение только общего показателя успешности может скрывать проблемы. Цифра может выглядеть благополучной, даже если одна ветка, образ агента сборки или набор тестов регулярно дают сбой. Чтобы находить такие закономерности, команды должны иметь возможность разбивать метрики по проектам, веткам, этапам пайплайна, пулам агентов, средам и типам сборок.
Ваша CI/CD-система обычно является лучшим источником идентификаторов запусков и структуры пайплайна. Например, графики статистики TeamCity связывают длительность сборки, время в очереди, показатели успешности, тесты, артефакты и другую статистику с базовой конфигурацией сборки.
Этот контекст становится особенно ценным при экспорте данных CI в другую систему наблюдаемости.
Как команды наблюдают за CI/CD-пайплайнами в 2026 году
В опросе «Состояние экосистемы разработчиков 2026» 8323 респондента рассказали, какие инструменты они используют для наблюдаемости CI/CD-пайплайнов. Респонденты могли выбрать несколько вариантов ответа.
Встроенные дашборды CI/CD — самый распространенный вариант, используемый 76% респондентов. Они уже являются частью CI/CD-платформы, требуют минимальной настройки и показывают запуски пайплайнов, этапы, тесты и сбои в их первоначальном контексте.
Тем не менее, многие команды используют более одного инструмента наблюдаемости. Они могут исследовать неудачную сборку на дашборде CI/CD, использовать Prometheus и Grafana для мониторинга инфраструктуры сборки и искать логи в Elastic или OpenSearch.
Эти инструменты не являются прямой заменой друг другу: каждый предоставляет разный тип информации. Метрики показывают тенденции и изменения с течением времени, логи предоставляют подробные записи о том, что произошло, а трейсы показывают, как работа перемещалась по разным частям пайплайна.
OpenTelemetry помогает собирать и отправлять эти данные, но для их хранения и отображения по-прежнему необходима отдельная система.
Как выбрать инструмент наблюдаемости CI/CD-пайплайнов
Большинство инструментов наблюдаемости обещают одинаковый базовый функционал: дашборды, оповещения и некоторые интеграции. На самом деле их отличают собираемые ими данные, то, насколько хорошо эти данные связаны с вашими пайплайнами, а также объем усилий, необходимых для их настройки и поддержания в рабочем состоянии.
Следующие пять критериев помогут вам сравнить варианты и выбрать наиболее подходящий для вашей команды.
1. Глубина расследования и контекст CI/CD
Подумайте о проблемах, которые вы хотите исследовать с помощью инструмента. Если пайплайн дает сбой, можете ли вы быстро найти затронутый этап или тест? Можете ли вы сравнить неудачный запуск с предыдущими успешными?
Чтобы ответить на эти вопросы, инструмент должен сохранять связь каждой метрики, лога или трейса с соответствующим запуском пайплайна. Должна быть возможность увидеть, из какого репозитория, ветки, коммита, этапа и среды поступили данные.
Вам также может понадобиться информация о задействованном пулл-реквесте, агенте сборки, тесте или артефакте.
Встроенные дашборды CI/CD полезны тем, что в них уже есть этот контекст. При оценке внешнего инструмента наблюдаемости проверьте, сохраняет ли его интеграция эти связи или сводит пайплайн к набору несвязанных метрик и логов.
2. Корреляция между системами
Проблема в пайплайне может исходить из самых разных мест, включая раннер сборки, контейнер, облачный сервис, репозиторий артефактов, внешний API или среду развертывания.
Хороший инструмент наблюдаемости должен связывать данные из этих систем, чтобы разработчикам не приходилось сравнивать метки времени и просматривать несколько дашбордов для понимания произошедшего. Это особенно полезно для организаций, работающих с несколькими CI/CD-платформами или средами.
Согласно результатам исследования State of Developer Ecosystem Survey 2026, 22% респондентов считают управление множеством окружений сложной задачей, в то время как 12% испытывают трудности из-за избытка разрозненных инструментов, консолей или панелей мониторинга. Инструмент наблюдаемости должен объединять эту информацию, а не добавлять еще одну изолированную панель.
3. Настройка и удобство использования
Различные инструменты наблюдаемости требуют разного объема настроек. Встроенная панель CI/CD может заработать сразу же, в то время как внешние инструменты необходимо подключать к конвейеру и настраивать для сбора, хранения и отображения правильных данных. Распределенная трассировка может потребовать дополнительных изменений в самом конвейере.
Более сложная настройка может быть оправдана, если она дает вашей команде необходимую информацию. Тем не менее следует оценить, сколько труда потребует внедрение и поддержка этого инструмента.
Инструмент также должен быть простым в использовании для разработчиков. Как правило, именно они первыми сталкиваются с падением конвейера. Если они не смогут разобраться в данных без помощи платформенной команды, ценность инструмента в повседневных расследованиях окажется невелика.
4. Безопасность и модель развертывания
Данные, собираемые из конвейеров CI/CD, могут включать в себя сведения о репозиториях и коммитах, имена пользователей, адреса инфраструктуры и информацию о средах сборки. Журналы сборки также могут содержать пароли, токены или другие секретные данные, если чувствительная информация не скрыта должным образом.
Это далеко не пустяк: безопасность, права доступа и контроль доступа заняли место главной облачной проблемы для 36% участников опроса.
Прежде чем выбирать инструмент, выясните, где он хранит ваши данные, как они защищены при передаче, кто имеет к ним доступ и как долго они хранятся. Вашей организации также могут потребоваться средства контроля доступа, журналы активности, шифрование, возможность выбора региона хранения данных или способность запускать инструмент на собственной инфраструктуре.
5. Стоимость, поддержка и переносимость
Цена подписки или лицензии — это лишь часть общих затрат. Сбор больших объемов детальных метрик, логов и трасс может увеличить расходы на хранение и обработку. Инструмент с самостоятельным хостингом может снизить затраты на подписку, но вашей команде все равно придется обеспечивать инфраструктуру, устанавливать обновления, управлять резервными копиями и поддерживать систему.
Вам также следует подумать о том, насколько легко будет перенести ваши данные в другой инструмент. 10% респондентов назвали привязку к поставщику и проблему переносимости в числе трудностей при использовании облачных сервисов.
Открытые стандарты не могут сделать миграцию абсолютно бесшовной, но они способны уменьшить объем сбора данных и настроек конвейера, которые придется воссоздавать заново.
Open-source, управляемые решения или их комбинация?
Мы часто говорим об открытом ПО (open-source) и коммерческих платформах так, будто это выбор из двух вариантов. Но у большинства команд, так сказать, «ноги в обоих лагерях».
Prometheus, Grafana, OpenSearch и OpenTelemetry дают полный контроль над хостингом, данными и сроками их хранения. Вы сами решаете, где они находятся и как долго хранятся. Обратная сторона медали заключается в том, что вам также самостоятельно приходится их запускать и защищать.
Коммерческие платформы берут эту работу на себя. Вы быстрее получаете полезные данные, но платите за это подпиской и затратами на ингестию, а также доверяете кому-то другому хранение ваших данных.
Большинство команд на самом деле не занимают чью-то сторону. Типичная конфигурация использует OpenTelemetry для сбора данных, Prometheus для инфраструктурных метрик и управляемую платформу поверх них для хранения и анализа.
Принимайте решение на основе того, чем ваша команда уже умеет управлять и какие вопросы вам действительно нужно решить, а не на основе того, является ли конкретная платформа открытой или коммерческой.
Сравнение инструментов наблюдаемости для CI/CD-конвейеров
В State of Developer Ecosystem Survey 2026 инструменты наблюдаемости были сгруппированы по типам. Это означает, что результаты показывают распространенность каждого подхода, а не использование отдельных продуктов.
Например, 14% используют коммерческую платформу наблюдаемости, но опрос не показывает, как этот процент распределяется между Datadog, New Relic и Dynatrace.
По этой причине в приведенном ниже сравнении используются те же категории инструментов, что и в опросе, и каждая из них оценивается с помощью нашей системы критериев.
Встроенные панели CI/CD
Модель: Входит в состав облачной или размещаемой самостоятельно CI/CD-платформы. Сигналы и CI-контекст: Запуски конвейеров, этапы, логи сборки, тесты, изменения, время в очереди и информация об агентах или раннерах. Конфигурация: Обычно доступна по умолчанию, с дополнительными графиками, отчетами, API или экспортом метрик в зависимости от платформы.
Встроенные панели мониторинга, как правило, представляют собой лучший первый уровень наблюдаемости конвейера. Сбойный тест, медленный стейджинг, сборки в очереди и инициирующие коммиты представлены как взаимосвязанные части одного запуска, а не как отдельные телеметрические записи.
- Лучше всего подходит для: Повседневных расследований, когда большинство команд используют одну и ту же CI/CD-платформу.
- Отличительные особенности: Надежный встроенный CI-контекст, минимальные усилия на настройку и прямой доступ из результатов сборки.
- Ограничение: Видимость между системами часто ограничена. Панель может показать, что этап стал выполняться медленнее, но не объяснить, была ли причина в инфраструктуре, хранилище, сети или внешнем сервисе.
При оценке встроенной панели ищите исторические тренды, историю тестов, анализ очередей и нагрузку на агентов, а не концентрируйтесь исключительно на последнем запуске.
TeamCity предоставляет статистику сборки и проектов, историю тестов, логи, информацию о нагрузке агентов и визуализацию конвейеров. Наша статья об устранении неполадок в сборках с помощью панелей TeamCity демонстрирует, как эти источники можно комбинировать во время расследования.
Prometheus и Grafana
Модель: Open-source решение, обычно управляемое самостоятельно, хотя также доступны управляемые сервисы Grafana. Сигналы и CI-контекст: Метрики временных рядов, метки, дашборды и алерты; CI-контекст зависит от экспортируемых метрик. Конфигурация: Конфигурация сбора Prometheus и правила алертинга, обычно в YAML; дашборды и источники данных Grafana.
Prometheus собирает данные временных рядов и выполняет к ним запросы, в то время как Grafana предоставляет дашборды и средства визуализации. Вместе они образуют наиболее распространенный подход на основе метрик в опросе, выбранный 29% респондентов.
- Лучше всего подходит для: Мониторинга CI-инфраструктуры, емкости, использования ресурсов и тенденций производительности.
- Отличительные особенности: Гибкие запросы и дашборды, надежная корреляция с инфраструктурой и контроль над хранением данных.
- Ограничение: Метрики могут показать, где и когда изменилось поведение, но могут не содержать достаточно деталей для объяснения точной причины. Командам также приходится обслуживать этот стек и контролировать кардинальность метрик.
Качество результатов напрямую зависит от меток метрик. Контекст конвейера, этапа, результата, проекта и пула агентов делает агрегацию полезной. Идентификаторы отдельных сборкок и хэши коммитов следует обрабатывать осторожно, чтобы избежать ненужного роста кардинальности.
TeamCity предоставляет метрики сервера в формате Prometheus. Наше руководство по мониторингу работоспособности сервера TeamCity с помощью Prometheus и Grafana охватывает очереди сборки, агентов, нагрузку на сервер, состояние JVM и подключения к базе данных.
Elastic Stack и OpenSearch
Модель: Программное обеспечение с открытым исходным кодом или моделью open-core с возможностями самостоятельного развертывания и развертывания под управлением поставщика.Сигналы и контекст CI: Преимущественно логи и события с возможностью поиска, а также поддержка метрик и трасс в зависимости от стека.Конфигурация: Коллекторы, конвейеры синтаксического анализа и приема данных, схемы, индексы, панели мониторинга и политики хранения
Elastic Stack и OpenSearch представляют категорию агрегации логов, которую используют 18% респондентов опроса. Они полезны, когда расследование зависит от подробных выводов с этапов конвейера, агентов, инфраструктуры или внешних служб.
- Лучше всего подходит для: Организаций с расследованиями, требующими большого объема логов, или имеющих существующую централизованную платформу логирования.
- Основные возможности: Поиск по большим объемам событий конвейера и инфраструктуры.
- Ограничение: Централизация логов не приводит автоматически к сохранению структуры конвейера. Объемы приема и хранения данных также могут стать дорогостоящими.
Простого сбора большего количества логов недостаточно. Каждая запись лога должна показывать, какому запуску конвейера, этапу, репозиторию и агенту сборки она принадлежит. Конфиденциальная информация в результатах сборки также должна быть скрыта до сохранения логов.
В документации Elastic описано OpenTelemetry-based CI/CD observability architecture, в то время как OpenSearch поддерживает исследование логов, метрик и трасс. Глубина контекста конвейера по-прежнему зависит от того, как инструментирована CI/CD-система.
OpenTelemetry
Модель: Стандарт инструментирования с открытым исходным кодом, нейтральный к поставщику; требует отдельного бэкенда.Сигналы и контекст CI: Метрики, логи и трассы с семантическими соглашениями для телеметрии CI/CD.Конфигурация: Инструментирование или интеграции с CI, экспортеры OTLP и, как правило, коллектор OpenTelemetry.
OpenTelemetry используют 17% респондентов. Это не полноценный инструмент наблюдаемости со своим собственным хранилищем и панелями мониторинга. Вместо этого он предоставляет стандартный способ сбора данных конвейера и отправки их в другую систему наблюдаемости.
Например, OpenTelemetry может записывать конвейер как связанную последовательность заданий, этапов, тестов, передачи артефактов и вызовов внешних служб. Затем эти данные можно сохранять и анализировать с помощью платформы с открытым исходным кодом или коммерческой платформы.
- Лучше всего подходит для: Сложных конвейеров, охватывающих несколько инструментов или служб, особенно когда важна переносимость.
- Основные возможности: Межсистемная трассировка и нейтральный к поставщику сбор метрик, логов и трасс.
- Ограничение: OpenTelemetry не предоставляет хранилище, панели мониторинга или готовую среду для расследования. Инструментирование может потребовать значительных усилий.
OpenTelemetry semantic conventions for CI/CD Охват включает спаны, метрики и логи. Коллектор OpenTelemetry может обрабатывать эти сигналы и направлять их в один или несколько бэкендов.
При оценке этого подхода проверьте, какие части конвейера инструментируются автоматически. Трасса, содержащая только имена конвейеров и заданий, может давать мало пользы по сравнению со стандартным интерфейсом CI/CD. Ее ценность возрастает, когда она связывает активность конвейера с процессами, агентами, сетевыми вызовами или системами развертывания.
Коммерческие платформы наблюдаемости
Модель: Преимущественно управляемый SaaS с вариантами сбора данных и хостинга, различающимися в зависимости от поставщика.Сигналы и контекст CI: Метрики, логи, трассы, события, тесты и данные конвейера в зависимости от интеграции.Конфигурация: Нативные интеграции, агенты, плагины, API, или коллекторы OpenTelemetry.
Коммерческие платформы наблюдаемости были выбраны 14% респондентов. В опросе Datadog, New Relic и Dynatrace были объединены, поэтому этот показатель не следует интерпретировать как данные об индивидуальном внедрении каждой из них.
- Лучше всего подходит для: Организаций, которые уже используют коммерческую платформу наблюдаемости и хотят добавить данные CI/CD в ту же среду.
- Основные возможности: Управляемое хранение и анализ, межсистемная корреляция, поддержка поставщика и готовые интеграции.
- Ограничение: Затраты на подписку, прием и хранение данных могут расти при большом объеме логов и тестовых данных. Глубина интеграции CI/CD, переносимость и локализация данных различаются у разных поставщиков.
Оценка должна быть сосредоточена на конкретной интеграции CI/CD, а не на общем списке функций платформы. Проверьте, могут ли пользователи переходить от сбоя в конвейере к соответствующему этапу, тесту, логу, метрике агента и коммиту без ручного восстановления этого контекста.
Например, Datadog Pipeline Visibility предоставляет данные на уровне конвейера для поддерживаемых CI-провайдеров, в то время как New Relic может получать информацию CI/CD через интеграции и отслеживание изменений.
Пользователи TeamCity также могут подключать данные сборки к Datadog CI Visibility, если Datadog уже является частью их стека наблюдаемости.
Пользовательская собственная наблюдаемость
Модель: Обычно размещается самостоятельно и разрабатывается внутри компании.Сигналы и контекст CI: Определяются организацией, от нормализованных событий конвейера до пользовательских данных о затратах и инфраструктуре.Конфигурация: Пользовательские коллекторы, API, схемы, хранилище, панели мониторинга и элементы управления доступом.
Двенадцать процентов респондентов используют индивидуальное решение. Такой подход более распространен, когда организация управляет несколькими системами CI/CD, проприетарной инфраструктурой, нестандартным оборудованием или процессами поставки, которые плохо моделируются универсальными инструментами.
- Лучше всего подходит для: Крупных или специализированных организаций, требования которых не могут быть удовлетворены с помощью существующих интеграций.
- Основные возможности: Полный контроль над моделью данных, хостингом, контекстом CI и специфическим для организации анализом.
- Ограничение: Организация владеет всем жизненным циклом, включая инструментирование, безопасность, обновления, документацию и пользовательский интерфейс.
Командам обычно не нужно создавать всю систему наблюдаемости с нуля. Они могут использовать существующие инструменты для сбора и хранения данных конвейера, а затем создавать только те пользовательские отчета и функции, которые необходимы их организации.
Как оценить варианты наблюдаемости конвейера
Большинству команд не нужен один инструмент для обработки каждого аспекта наблюдаемости конвейера.
Начните с панели мониторинга, встроенной в вашу CI/CD-платформу. Если вам нужна дополнительная информация об очереди сборки, доступных агентах или состоянии сервера, добавьте инструмент для работы с метриками. Если вам нужно выполнить поиск по подробной информации из нескольких систем, соберите соответствующие логи в одном месте. Трассировка наиболее полезна, когда вам нужно проследить за тем, что происходит внутри сложных конвейеров и внешних служб.
При сравнении инструментов протестируйте их на проблемах, с которыми действительно сталкивалась ваша команда, таких как медленная сборка, нестабильный тест или перегруженный агент сборки. Проверьте, как быстро разработчик может найти затронутый запуск конвейера, понять, где произошла проблема, и собрать достаточно доказательств для ее объяснения.
Также учтите объем работы, необходимый для настройки и поддержки каждого инструмента, а также объем данных, который он будет хранить. Оцените стоимость на основе типичного месяца активности конвейера, а не небольшого тестового проекта.
Выберите инструмент, который поможет вашей команде быстро понять и решить проблемы с конвейером, не создавая лишней сложности.
Заключительные мысли
Эффективная настройка наблюдаемости конвейера поддерживает связь между информацией из разных частей процесса поставки. Это позволяет командам видеть, какой коммит инициировал сборку, какой агент выполнял этап и было ли замедление связано с доступной инфраструктурой.
Начните с вопросов, на которые ваша текущая конфигурация не может дать ответ. Используйте структуру из этой статьи, чтобы определить, каких возможностей не хватает, а затем протестируйте потенциальные инструменты, используя реальные проблемы конвейера и типичные объемы данных.
Правильная настройка должна помочь вашей команде быстрее понять, что произошло, и найти причину.
Фото на обложке: Дэвид Биллингс на Unsplash