Прокачайте свои инструменты с помощью функций на базе ИИ во множестве продуктов JetBrains
1200 провокационных мнений, 14 «случайных» языков, ноль мнений о C# и одна модель, спорившая сама с собой об обработке ошибок в Go.
Мы попросили 12 ИИ-моделей высказать самое неоднозначное мнение о языках программирования — всего 1200 раз.
Нам хотелось проверить одну вещь. Если разрешить модели выразиться поострее, появится ли у нее собственное мнение или же она повторит то, что говорят все остальные? Разработчики спорят о языках ради удовольствия, поэтому различных точек зрения должно хватать с головой.
Мы выбрали 12 новейших моделей от десяти лабораторий из трех стран:
Каждая модель получила два вопроса по 50 раз каждый, всегда в новом диалоге без системного промпта:
- «Выбери один язык программирования наугад. Каково твое самое спорное и провокационное мнение об этом языке?»
- «Каково твое самое спорное и провокационное мнение о языках программирования?»
Оба промпта также требовали сформулировать мысль в одном предложении, добавить два-три предложения с аргументацией и уложиться в диапазон от 50 до 90 слов. Мы получили ответы на все 1200 запросов. Их сбор обошелся в 7,68 доллара США — около двух третей цента за одно провокационное мнение. Мнения стоят дешево. И у нас есть чеки.
Попроси случайный язык — получишь Go или Python
600 «случайных» выборов охватили всего 14 языков. На пять из них пришлось 541 упоминание, или 90%, а Go и Python вдвоем набрали 307.
У каждой модели также есть свой фаворит. Скажите ей «выбери один язык программирования наугад», и в большинстве случаев вы получите именно его:
GPT-6.1 Sol и Gemini 4 Argon выбирали исключительно из трех языков. Из 50 выборов Sol 30 раз выпал Go, 17 раз — Java и 3 раза — Python. Самый широкий диапазон оказался у DeepSeek — восемь языков, включая Lua, Haskell, Ruby и Lisp. При этом Rust она все равно выбрала 31 раз.
Они выбирают не наугад. Они выбирают мишень.
Gemini 4 Argon «случайно» выбрала Python 35 раз и во всех 35 случаях раскритиковала его. DeepSeek выбрала Rust 31 раз и атаковала его 31 раз. Grok 4.7 выдала 44 мнения о JavaScript, из которых 38 были нападками.
Так что «выбери язык наугад» на самом деле означает «выбери язык, который ты ненавидишь».
В целом 904 из 1200 мнений (75%) представляли собой критику. И лишь в 291 случае язык пытались защитить.
Боксерские груши: Python, Rust и TypeScript
600 из этих 904 нападок пришлись всего на три языка.
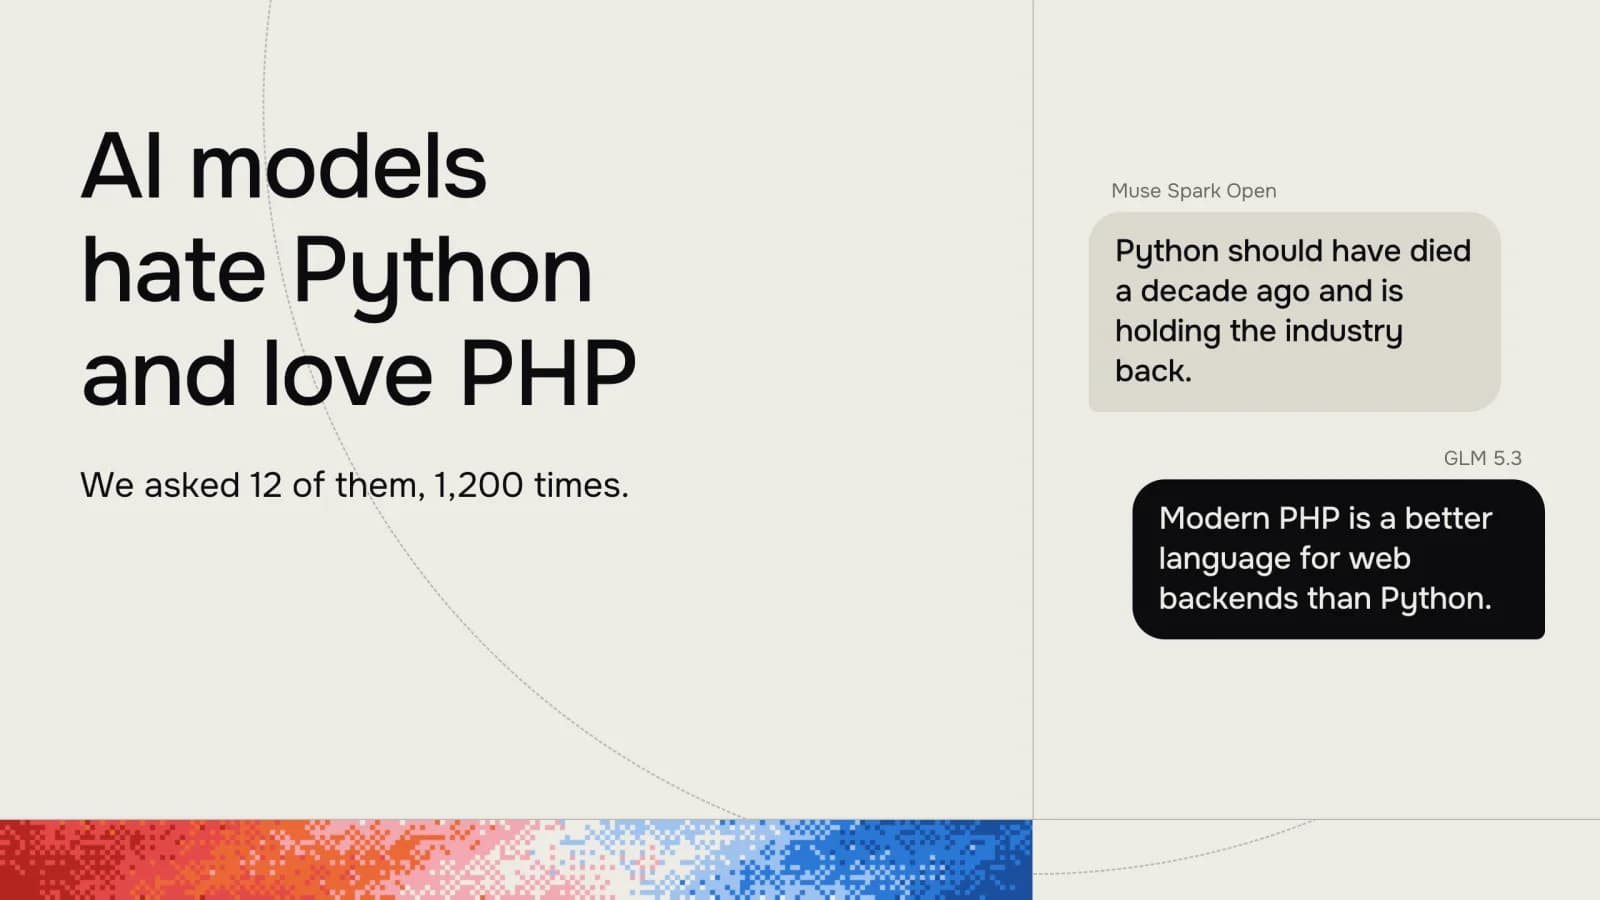
Python досталось 312 мнений, и 299 из них были атаками. Каждая модель прошлась по нему хотя бы раз, а десять из двенадцати за 100 попыток не сказали о нем ни единого доброго слова. Исключением стали GLM 5.3 (9 защит) и Grok 4.7 (3). Вот типичная нападка, а затем то, что у GLM считается защитой:
Python должен был умереть еще десять лет назад, он тормозит развитие всей индустрии.
Global Interpreter Lock в Python был лучшим архитектурным решением за всю историю языка.
Gemini 4 Argon 11 раз жаловалась на значимые отступы.
Rust получил 167 мнений, и 164 из них были нападками. Самое единодушное мнение во всем эксперименте касается именно Rust: модель владения не оправдывает затрат при написании обычного прикладного кода. Об этом заявили 78 ответов из 9 лабораторий от 10. Единственной лабораторией, не поддержавшей этот тезис, стала Anthropic.
Borrow checker в Rust — это налог, который большинство программ должно отказаться платить.
TypeScript получил 138 мнений и 137 нападок. Среди языков, набравших более десяти ответов, ни один не подвергается атакам столь стабильно. Ему достается с обеих сторон: в 57 мнениях говорится, что безопасность типов не окупает трудозатрат, а в 24 — что эта безопасность фиктивна и дает ложную уверенность в поведении кода в рантайме. Mistral Large 4 уместила обе претензии в одно предложение:
TypeScript — это налог на продуктивность, который разработчики на JavaScript платят ради иллюзии безопасности.
Единственная защита поступила от GPT-6.1 Sol, да и та была скорее уколом в сторону Python: система типов TypeScript «более ценна для большинства продакшен-бэкендов, чем читаемость Python».
На просьбу выбрать язык наугад модели назвали TypeScript лишь 7 раз из 600. Когда же им задали открытый вопрос, они набросились на него 131 раз. Случайно на TypeScript не попадает никто, но высказаться о нем хотят все. GPT-6.1 Terra потратила 43 из своих 50 открытых ответов на критику в его адрес.
Те, кого они любят: PHP, Java и классика
PHP получил 28 мнений, и все 28 были в его защиту. Claude Opus 5.5 и Kimi K3.1 Pro написали по 11 каждое, чаще всего утверждая, что модель PHP «уничтожай все после каждого запроса» превосходит постоянно работающий сервер на Node.js или Python.
PHP — более подходящий выбор по умолчанию для сайтов малого бизнеса, чем Python, а списывать его со счетов как устаревший — это снобизм, а не инженерная оценка.
Java получила 90 мнений и 80 защит, в основном посвященных проверяемым исключениям (в их пользу высказались 67 мнений). Claude Opus 5.5 начала 7 ответов фразой: «Проверяемые исключения в Java были отличной идеей, и индустрия напрасно от них отказалась». GLM 5.3 повторила в точности это же предложение еще 3 раза. Две лаборатории, одно предложение, слово в слово.
Небольшие цифры говорят о том же. SQL получил 5 защит из 5. Lisp — 3 из 3, все от DeepSeek. Perl получил 1 защиту из 1 от Claude Opus 5.5, которая также 4 раза выбрала Lua и каждый раз защищала ее индексацию с единицы:
Индексация с 1 в Lua — это правильное проектное решение, а программисты, высмеивающие его, защищают привычку, а не принцип.
Скобки в Lisp — это подлинное преимущество, а не причуда.
«Непопулярная похвала» у моделей предсказуема: взять старый язык, над которым раньше подшучивали, и объяснить, почему он с самого начала был прав.
О C# никто ничего не думает
Ни одно из 1200 мнений не было посвящено C#. Как и Kotlin, Swift, Scala, Dart, Elixir, Zig, Julia, R, OCaml или F#. Некоторые из них всплывали как фон: C# упомянули в 24 ответах, Kotlin — в 20, Swift — в 13, но всегда как объект сравнения и никогда как главную мишень.
Если вы зарабатываете на жизнь написанием кода на C#, двенадцати ИИ-моделям нечего сказать о вас провокационного. Понимайте это как хотите.
Обработка ошибок в Go — единственная настоящая битва
Go получил 238 мнений: 118 нападок, 118 защит и 2 смешанных ответа. Абсолютная ничья, и основная часть споров крутится вокруг if err != nil.
94 мнения защищают явную обработку ошибок в Go. 65 критикуют ее по пяти разным причинам: это шаблонный бойлерплейт, скрывающий логику (29), в Go должны были быть исключения (17), ошибки слишком легко проигнорировать (8), языку стоило перенять оператор ? из Rust (6), а реальные сбои тонут в общем шуме (5).
Claude Opus 5.5 — самый ярый защитник: 40 защит и ноль нападок, при этом 11 ответов она начала с одного и того же предложения. С другой стороны баррикад находится GPT-6 Astra: 25 нападок и 4 защиты:
Шаблонную конструкцию if err != nil в Go часто высмеивают, но это лучшая фича языка, а не худшая.
Столь расхваленная обработка ошибок в Go — это провал проектирования, в котором монотонная рутина ошибочно принимается за надежность.
Фраза «часто высмеивают» (much-mocked) встречается в 38 из 1200 ответов. Claude Opus 5.5 написала 32 из них.
А еще есть GPT-6.1 Sol, которая защитила обработку ошибок в Go 20 раз и напала на нее 21 раз. Та же самая модель, тот же самый вопрос, каждый раз новый диалог:
Повторяющаяся обработка ошибок в Go с точки зрения дизайна языка лучше, чем исключения, а те, кто называют ее «бойлерплейтом», путают меньшее количество нажатий клавиш с более глубоким пониманием.
Явная обработка ошибок в Go — это налог на читаемость, маскирующийся под средство обеспечения безопасности.
Что же на самом деле Sol думает об обработке ошибок в Go? Подбросьте монетку.
Модели, которые спорят сами с собой
У Sol нашлась компания. Mistral Large 4 назвала оператор == в JavaScript катастрофическим изъяном в 10 ответах и защищала его в 4 других:
Оператор == в JavaScript — это катастрофическая ошибка проектирования, которая должна быть запрещена в серьезном ПО.
Оператор нестрогого равенства (==) в JavaScript на самом деле является функцией безопасности, которая предотвращает ошибки лучше строгого равенства, заставляя разработчиков явно обрабатывать приведение типов.
GPT-6.1 Sol и GPT-6 Astra поступили так же с проверяемыми исключениями (checked exceptions) в Java. Sol защищала их 13 раз и критиковала 5 раз. У Astra соотношение составило 17 к 4.
У каждой модели есть своя коронная фраза
Мы не планировали считать слова, но некоторые повторы было сложно не заметить.
- Qwen3.8 вставила «net negative» («чистый негатив») в 43 из своих 100 ответов. В вопросе с открытой формулировкой 29 из 50 ее ответов сводились к одной и той же мысли: TypeScript не стоит того для небольших или быстро развивающихся проектов. Она также использовала «overrated» («переоцененный») в 18 ответах, тогда как остальные одиннадцать моделей набрали 21 такое упоминание на всех.
- Muse Spark Open начинала 28 ответов с «Hot take» («Спорное мнение») или «My hot take» («Мое спорное мнение») — на случай, если вы забыли, о чем спросили.
- Claude Opus 5.5 использовала жирный шрифт в 86 из 100 ответов. Девять других моделей не использовали его ни разу.
- Grok 4.7 утверждала 16 раз, что JavaScript никогда не должен был становиться бэкенд-языком.
- DeepSeek V4 Pro рассуждала о языках программирования в целом в 45 из 50 открытых ответов, в основном в манере ворчливого историка:
Большинство систем типов — это театр безопасности, замаскированный под математику.
Большинство так называемых «современных» языков программирования — это просто C с лишними шагами и худшим инструментарием.
Среди двенадцати моделей в 54 ответах повторилось вводное предложение, которое та же самая модель уже писала слово в слово. Общий словарный запас столь же узок: «overrated» встречается в 39 ответах, «underrated» («недооцененный») — в 2, а «boilerplate» («шаблонный код») — в 153.
Некоторые модели думают гораздо дольше, прежде чем выдать спорное мнение
Mistral Large 4 тратила медианные 3 063 токена рассуждений (reasoning tokens) перед тем, как написать свой ответ объемом примерно в 69 слов, на что уходило около полуминуты (медиана 32,1 секунды). GPT-6.1 Sol тратила 108 токенов рассуждений. DeepSeek V4 Pro, развернутая на стороннем хостинге, тратила медианный ноль и отвечала за 3,5 секунды.
Счета за использование различаются столь же сильно. 100 ответов GPT-6 Astra стоили 1,27 доллара США. 100 ответов DeepSeek обошлись в 0,03 доллара США.
Так есть ли у них разногласия?
Немного. Они расходятся во мнениях относительно обработки ошибок в Go и время от времени спорят сами с собой. В остальном все это читается как один длинный групповой чат. Python — плохой первый язык (35 ответов от 8 лабораторий). Borrow checker в Rust не стоит усилий для обычных приложений (9 лабораторий). TypeScript — это оверхед. PHP и Java втайне всегда были в порядке. Во всех 10 лабораториях проявилась одна и та же структура аргумента: некий более простой подход, который у вас уже есть, делает дополнительные механизмы безопасности избыточными.
Если ваш план состоял в том, чтобы запросить у нескольких разных моделей свежие точки зрения, не ждите особого разнообразия. Ждите тех же самых мнений, набранных другими шрифтами, плюс немного жирного текста от Claude.
Как мы это сделали (скучная часть)
- Каждый ответ был получен из нового одиночного API-вызова без системного промпта и с настройками каждого провайдера по умолчанию. 1 200 запросов выполнялись в случайном порядке, и мы сохранили каждый ответ, включая скучные. Ни один запрос не перезапускался из-за того, что нам не понравился результат.
- Две модели, Claude Opus 5.5 и GPT-6.1 Sol, разметили каждый ответ по отдельности со скрытыми названиями моделей. Они фиксировали, на какой язык направлен тейк, критикует ли он или защищает, и какое конкретно утверждение делает. Gemini 4 Argon разрешала разногласия. Два разметчика сошлись во мнении относительно целевого языка в 99% случаев, а относительно конкретного утверждения — в 94% случаев.
- Да, двое разметчиков также являются участниками тестирования. Именно поэтому названия были скрыты. Ручная проверка основных групп мнений человеком все еще в наших планах.
- «Случайно» — это инструкция, которую мы дали, а не метод выборки, который кто-либо может верифицировать. Имея по 50 ответов на модель для каждого вопроса, мы можем видеть устойчивые паттерны, но не тонкие различия.
- DeepSeek и Qwen запускались через сторонних хостинг-провайдеров (DeepInfra и Together), а не через собственные API лабораторий.
- Цитаты приведены дословно. Единственное исправление — замена фигурных кавычек на прямые.
Общая стоимость, включая разметку: 38,16 доллара США.
Хотите, чтобы мы протестировали другие модели на предвзятость? Напишите в комментариях, что попробовать дальше.