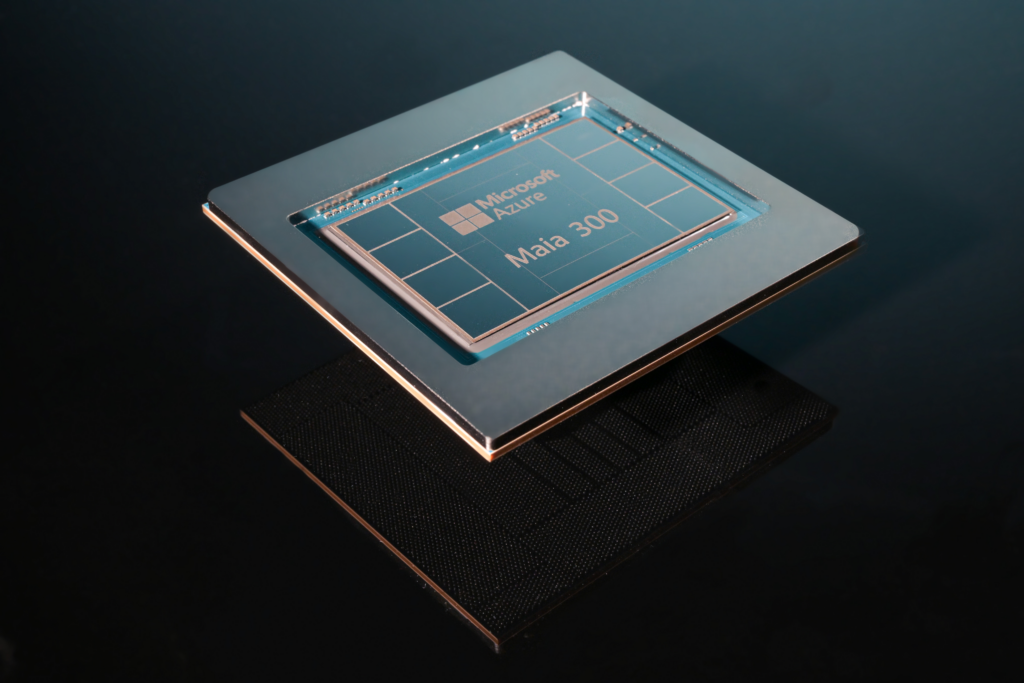
С момента своего зарождения Azure Maia строилась на единой архитектурной философии: оптимизировать всю систему для инференса больших языковых моделей (LLM) таким образом, чтобы каждый ватт и каждый доллар приносили больше интеллекта. Теперь, в своем третьем поколении, Maia 300 представляет собой наиболее полное воплощение этой философии. Maia 300 создана как целостная система, в которой программное обеспечение, кремний, инфраструктура физических стоек, сетевые технологии и дата-центры совместно спроектированы для работы в качестве единой платформы, отвечающей требованиям агентного инференса облачного масштаба.
Такой системный подход становится все более необходимым по мере того, как агентные рабочие нагрузки, включая многошаговое выполнение, декодирование с длинным контекстом и использование инструментов, изменяют профиль вычислений и арифметическую интенсивность инференса. Удовлетворение этих требований предполагает поддержание локальности, обеспечение вычислений достаточным объемом памяти и пропускной способностью, минимизацию перемещения данных, эффективное масштабирование коммуникаций и размещение максимального функционала в рамках фиксированного бюджета питания и охлаждения дата-центра.
В Microsoft мы воочию наблюдаем эту трансформацию благодаря продуктам и платформам, которые наши клиенты используют каждый день — от Microsoft Copilot и GitHub Copilot до Microsoft Foundry. Масштабная эксплуатация этих нагрузок дает нам уникальное представление о том, как ИИ внедряется в различных отраслях, а также об инфраструктуре, необходимой для поддержки нового поколения ИИ-приложений и агентов. Maia 300 разработана для максимизации полезных токенов на ватт и полезных токенов на доллар, предоставляя нашим клиентам больше возможностей, производительности и пропускной способности в этих продуктах и во всем портфеле ИИ-решений Microsoft.
Энергоэффективный инференс за счет потока данных, определяемого программным обеспечением
В Maia 200 был представлен новый класс архитектуры ускорителей под названием Software Defined Locally Accessed Dataflow Architecture, или SDLA. В ее основе лежит наблюдение, согласно которому эффективное управление данными, включая их хранение, перемещение и преобразование, является одной из центральных проблем в современных системах ИИ. Программируемая архитектура потока данных Maia отделяет программирование пути управления от выполнения пути данных и позволяет программному обеспечению явно координировать размещение, перемещение, преобразование и синхронизацию данных между специализированными локальными запоминающими устройствами, DMA-контроллерами, вычислительными ядрами и сетью.
Maia 300 развивает эту архитектуру для инференса с длинным контекстом, интенсивными рассуждениями и высокой нагрузкой на декодирование. Во-первых, память переходит от организации с единым доступом к памяти (UMA) в SoC к организации с учетом локальности неоднородной памяти (NUMA) на уровне чиплетов, что позволяет программному обеспечению размещать данные рядом с вычислениями, которые их используют. Во-вторых, новые форматы с узкой разрядностью и аппаратно ускоренным преобразованием типов данных сокращают количество байтов, перемещаемых для каждого токена. В-третьих, стойка удваивается до 96 ускорителей, а область масштабного расширения (scale-up) вырастает до суперпода из 12 288 ускорителей, что позволяет большему количеству ускорителей эффективно работать как единая система.
Вместо того чтобы масштабировать производительность исключительно за счет увеличения энергопотребления и площади кремния, Maia 300 улучшает производительность на ватт с помощью набора архитектурных инноваций, которые оптимизируют перемещение данных, локальность, точность и эффективность памяти в масштабе всей системы:
- Многочиплетная архитектура повышает производительность за счет размещения вычислений на техпроцессе TSMC N2P, где передовая технология обеспечивает наибольший прирост производительности на ватт, при этом функции контроллера памяти и ввода-вывода вынесены на кристаллы, оптимизированные по пропускной способности, возможностям подключения и стоимости. Это увеличивает площадь кремния, выделенную под вычислительную производительность, и позволяет каждой функции использовать технологию, наиболее подходящую для ее роли, в то время как SDLA управляет локальностью и перемещением данных внутри корпуса. Эта стратегия увеличивает вычислительные FLOPs системы на 36%, добавляет в 2,5 раза больше пропускной способности HBM и обеспечивает на 14% большую пропускную способность масштабного расширения.
- Оптимизированный инференс с низкой точностью, включающий улучшенные форматы хранения MXFP4 и суб-3-бит. Более узкие представления уменьшают объем памяти и перемещение данных, позволяя системе поддерживать более крупные модели, более длинный контекст и большее количество одновременных сеансов в рамках того же бюджета энергопотребления.
- Оптимизированное ядро инференса за счет усовершенствования системы команд (ISA): векторный модуль добавляет оптимизации для ключевых ядер инференса, включая softmax, низкоточное приведение типов данных и другие операции.
- Эффективное перемещение данных на кристалле: Maia 300 изменяет организацию памяти с однородной на неоднородную (NUMA) между чиплетами. Каждый вычислительный регион имеет близлежащую память, а явное управление SDLA над DMA-контроллерами, локальной SRAM, HBM и сетью на кристалле размещает данные рядом с вычислениями, которые их используют. Данные преодолевают более короткие расстояния, что снижает энергозатраты на их перемещение.
- Иерархия памяти, оптимизированная по пропускной способности на ватт, объединяет управляемую программным обеспечением SRAM на кристалле с восемью стеками HBM4, обеспечивающими 288 ГБ емкости и 18 ТБ/с пропускной способности на один ускоритель. Благодаря этому достигается увеличение пропускной способности памяти в 2,5 раза, емкости на 33% и примерно двукратное увеличение пропускной способности HBM на ватт, что позволяет удерживать большую часть модели и состояния KV ближе к вычислениям.
Maia 300 обеспечивает в 2,5 раза большую пропускную способность памяти, на 33% большую емкость и примерно в 2 раза большую пропускную способность HBM на ватт по сравнению с Maia 200
Maia 300 обеспечивает в 2,5 раза большую пропускную способность памяти, на 33% большую емкость и примерно в 2 раза большую пропускную способность HBM на ватт по сравнению с Maia 200
Единая коммутационная ткань масштабного расширения: от пода к суперподу
Maia 300 делает сеть нативным расширением своей архитектуры потока данных, определяемой программным обеспечением. Сетевой контроллер ИИ в Maia реализует специализированную транспортную ИИ-систему на базе Ethernet. Двухуровневая сеть создает высокопроизводительный суперпод, насчитывающий до 12 288 ускорителей. Maia представляет программному обеспечению единую модель коммуникации — те же семантические правила для прямого перемещения данных к любому ускорителю внутри суперпода.
- Топология с полукоммутацией внутри стойки: каждый ускоритель разделяет свои возможности подключения для масштабирования между прямыми соединениями и коммутируемыми путями. Прямые соединения связывают два ускорителя в полке, в то время как коммутируемая ткань соединяет все 96 ускорителей в стойке, образуя под. Все соединения внутри стойки используют электрические линии связи для снижения энергопотребления и стоимости.
- Оптический второй уровень между стойками: коммутаторы второго уровня соединяют до 128 стоек вместе, образуя суперпод. Оптика обеспечивает радиус действия, необходимый для расширения сети масштабного расширения по всем подам.
- Единая коммутационная ткань вместо раздельных доменов масштабного расширения и развертывания: встроенные сетевые контроллеры и специализированный ИИ-транспорт используют одинаковую семантику связи внутри пода и во всем суперподе. Ускорители Maia могут напрямую инициировать связь с любым ускорителем в суперподе без привлечения хоста или отдельной сетевой платы (NIC) для горизонтального масштабирования.
- Пути связи с низким числом переходов (low-hop): существует три домена задержки. Пара напрямую соединенных ускорителей образует домен с наименьшей задержкой, далее следуют ускорители внутри пода на расстоянии одного перехода коммутатора, а любой ускоритель в разных подах находится на расстоянии трех переходов коммутатора. Программное обеспечение может удерживать чувствительный к задержкам тензорно-параллельный трафик локально в пределах доменов с наименьшей задержкой.
- Пропускная способность, выделенная для рабочей нагрузки. Распределение полосы пропускания между внутристоечной и межстоечной скоростью на один ускоритель не фиксируется на этапе проектирования системы. Оно становится параметром, который задается на основе компоновки заданий. Ускоритель может обеспечивать скорость до 750 ГБ/с для любого узла в пределах суперпода, когда только часть ускорителей задействована между стойками. См. пример с резервной платой ниже.
- Гибкое размещение заданий. Тензорный параллелизм может оставаться в пределах 96-ускорительной стойки, в то время как более широкие экспертный параллелизм и параллелизм конвейера охватывают стойки. Задания могут использовать емкость, выходящую за рамки границ стойки, что сокращает количество простаивающих ускорителей, когда размеры рабочей нагрузки не соответствуют конфигурации физической стойки.
- Дизгрегированный вывод в пределах масштабируемого домена. Рабочие процессы предварительного заполнения (prefill) и декодирования (decode) могут настраиваться и размещаться независимо. После завершения вычислений предварительного заполнения состояние KV передается напрямую выбранным рабочим процессам декодирования через ту же сеть масштабирования, а не покидает домен по отдельному пути масштабирования через хост.
- Отказоустойчивость между стойками. Когда ускорители становятся недоступными, планировщики могут использовать емкость горячего резерва в другой стойке в пределах суперпода прозрачно для программных ядер. Рабочая нагрузка остается в сети масштабирования, обменивая дополнительную задержку пути на повышенную доступность и использование ресурсов.
Архитектура стоечного масштаба для эффективности развертывания
В масштабе датацентра эффективность определяется тем, какой объем полезной инфраструктуры может быть развернут и эксплуатируемый в рамках фиксированного лимита энергопотребления и охлаждения. Опираясь на базовую энергоэффективность архитектуры Maia SoC, стойка Maia 300 объединяет проектирование компоновки и плотности сервера, топологию сети и коммутацию, проектирование систем питания и охлаждения, а также передовую телеметрию для обеспечения до 2,5 раза большей производительности на ватт по сравнению с Maia 200.
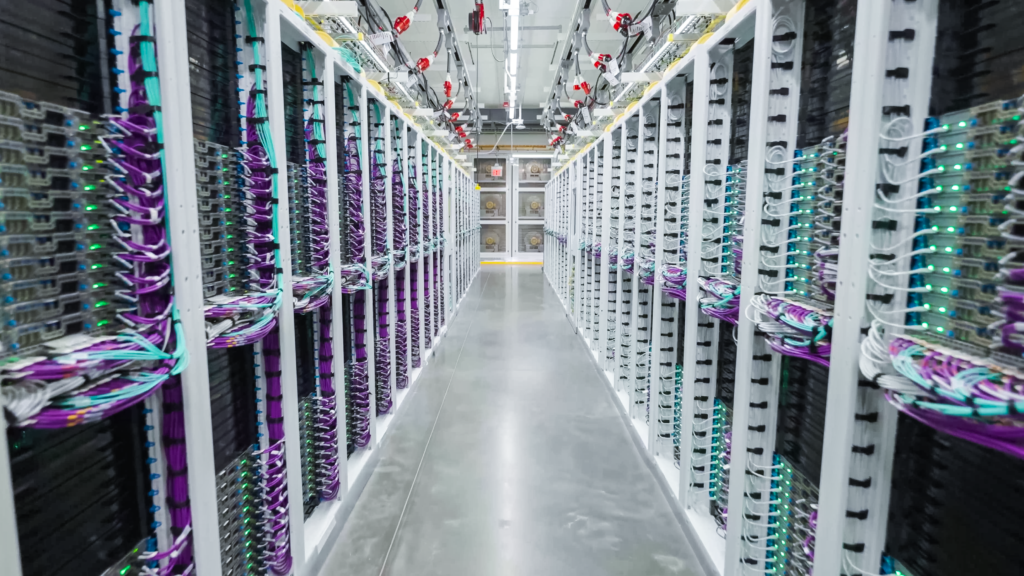
- 96 ускорителей в пределах 167 кВт. Maia 300 объединяет 96 ускорителей на 24 платах по четыре ускорителя в стойке мощностью 167 кВт, удваивая плотность ускорителей Maia 200. Каждая плата включает четыре ускорителя с хост-процессором, памятью, хранилищем и охлаждением. Устранение отдельной хост-платы высвобождает место в стойке и позволяет управлять ресурсами питания и терморегулирования как единой системой, увеличивая пропускную способность вывода, развернутую в каждой стойке.
- Консолидированная архитектура коммутаторов. Шесть высокорадиусных коммутационных ASIC интегрированы в три платы коммутаторов с жидкостным охлаждением, обеспечивая внутристоечное подключение, необходимое для всех 96 ускорителей, при минимизации занимаемого пространства и энергопотребления коммутацией.
- Электроснабжение на уровне стойки. Двойные вводы питания, мощные силовые полки и шинопровод на 50 В эффективно распределяют питание между платами ускорителей и коммутаторов, обеспечивая при этом эксплуатационное резервирование. Встроенный автоматический ввод резерва стойки поддерживает высокую доступность, даже когда один ввод питания отключен для обслуживания.
- Гибкая архитектура охлаждения. Жидкостное охлаждение удаляет более 80% тепловой нагрузки стойки от ускорителей, регуляторов напряжения и ASIC коммутаторов, в то время как воздушное охлаждение поддерживает память, хранилище и другие вспомогательные компоненты. Maia 300 может подключаться напрямую к системе водоснабжения объекта, если она доступна, или использовать блок теплообменника для отвода тепла в датацентрах с воздушным охлаждением. Это обеспечивает большую гибкость в отношении того, где и как система может быть развернута в масштабе.
- Интегрированная с датацентром телеметрия. Мы внедрили опыт развертывания для повышения надежности, готовности и удобства обслуживания (RAS), наблюдаемости, отладки, обработки сбоев и резервирования, повышая надежность по мере развертывания дополнительных объемов. Телеметрия питания на уровне стоек и рядов подключается с операциями датацентра, позволяя управлять рабочими точками с учетом доступной мощности и емкости охлаждения. Эти данные формируют алгоритмы, которые динамически распределяют питание и оптимизируют размещение рабочих нагрузок и плотность развертывания, улучшая использование и количество токенов на ватт.
Что предлагает Maia 300
Maia 300 — это следующий шаг в многопоколенной программе по развертыванию эффективных систем ИИ в масштабе. Дизайн оптимизирован сквозным образом в отношении программного обеспечения, кремния, физической инфраструктуры стоек, сетей и датацентров, чтобы обеспечить качественный скачок производительности и эффективности для агентного вывода облачного масштаба.
Relative to Maia 200, Maia 300 обеспечивает до 7 раз большую пропускную способность токенов в масштабе стойки в своей полной конфигурации из 96 ускорителей и более чем в 2,5 раза большую производительность на ватт. Она предлагает большую пропускную способность памяти на ватт и вдвое больше ускорителей на стойку, опираясь на SDLA — нашу программно-определяемую архитектуру потока данных и двухуровневую сеть масштабирования для поддержки единой модели программирования, охватывающей уровень от ядра до датацентра. В совокупности эти достижения позволяют нам доставлять более полезный интеллект с большей эффективностью еще большему числу людей и организаций.
Maia 300 обеспечивает до 7 раз большую пропускную способность токенов в масштабе стойки и более чем в 2,5 раза большую производительность на ватт по сравнению с Maia 200
Maia 300 обеспечивает до 7 раз большую пропускную способность токенов в масштабе стойки и более чем в 2,5 раза большую производительность на ватт по сравнению с Maia 200
Будущая задача заключается не просто в создании дополнительных вычислительных мощностей. Она заключается в том, чтобы сделать передовые возможности ИИ более доступными, недорогими и полезными. Maia 300 — это важный шаг к этой цели.
В следующем месяце на Microsoft Ignite 2026 в Сан-Франциско и онлайн мы будем рады поделиться дополнительной информацией о нашей стратегии в области ИИ, тенденциях внедрения технологий и успехах в трансформации рубежей.
Читайте о последней .
Узнайте больше о Azure Maia 300 here.
Узнайте больше о подходе Azure от кремния к системам здесь.