
Если вы новичок в фаззинге и хотите сначала изучить основы, ознакомьтесь с нашим курсом Fuzzing 101 на gh.io/fuzzing101.
Непрерывный фаззинг — это не волшебное решение, которое решает все ваши проблемы. Даже проекты, которые годами участвуют в OSS-Fuzz, все еще могут скрывать критические ошибки, и причина почти всегда одна и та же: кому-то нужно следить за покрытием, писать новые обертки (harnesses) для кода, до которого никто не добирается, и проводить триаж сбоев на выходе. Другими словами, в фаззинге по-прежнему необходим человек.
Поэтому закономерный вопрос, который я задавал себе: какую часть этой ручной работы мы действительно можем переложить на агента LLM?
Это привело меня к созданию Fuzzing Taskflow — автономного конвейера фаззинга для проектов на C/C++. Вам нужно лишь указать репозиторий на GitHub, а все остальное он сделает сам: определит подходящие точки входа, проанализирует систему сборки, напишет обертки, запустит AFL++, прочитает отчеты о покрытии, улучшит обертки, выполнит триаж каждого сбоя и напишет отчет об уязвимости для каждой уникальной ошибки, и все это без человеческого контроля.
Fuzzing Taskflow построен на базе GitHub Security Lab Taskflow Agent — нашего фреймворка для написания средств автоматизации безопасности на базе LLM, поэтому конвейер представлен в виде набора рабочих процессов, которые агент выполняет от начала и до конца.
В этой статье я расскажу, как это работает и какие проектные решения за этим стоят. Давайте начнем!
Как запустить
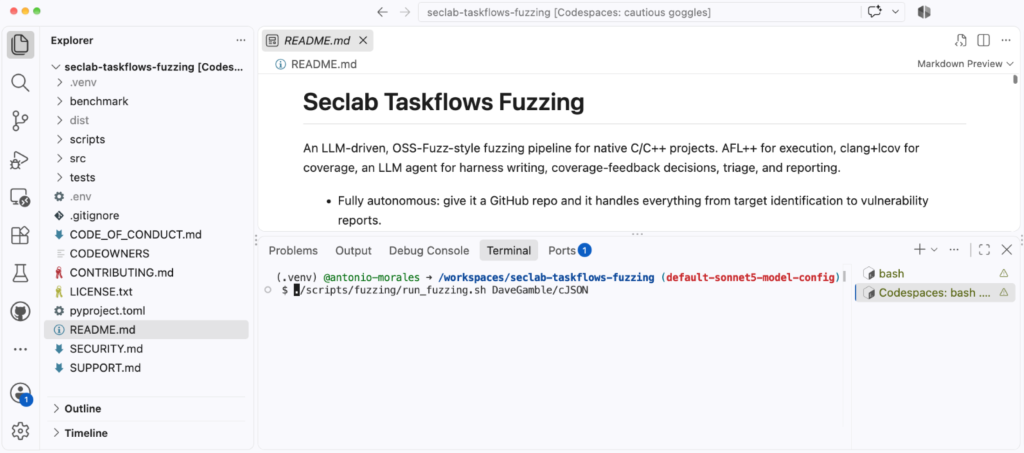
Самый простой способ запустить его — перейти на https://github.com/GitHubSecurityLab/seclab-taskflows-fuzzing и запустить codespace.
Затем выполните скрипт следующим образом:
Например:
Вот и все. В качестве аргумента передается только сокращенное имя владельца/репозитория GitHub. После этого агент самостоятельно выполняет все предварительные шаги:
- Установка такого программного обеспечения, как AFL
- Клонирование репозитория
- Определение наиболее релевантных функций в коде
- Создание целей фаззинга для этих функций
Если вам нужен быстрый дымовой тест перед запуском долгой кампании, укажите что-нибудь небольшое:
Предупреждение перед запуском: этот рабочий процесс запускает afl-fuzz, clang и произвольные команды сборки, выбранные LLM, напрямую на хосте, без промежуточного контейнера. Агент с инъекцией промпта в принципе может делать все то же самое, что и ваш пользователь. Поэтому запускайте его только в изолированной среде (например, в Codespace или временной ВМ) без повышенных привилегий.
Выбор модели
Некоторые передовые модели накладывают ограничения безопасности на свои выводы. Для рабочего процесса фаззинга мы по умолчанию используем Claude Sonnet 5, так как он прошел все наши внутренние тесты без проблем. Вы можете выбрать другую модель, изменив следующий файл: src/seclab_taskflows_fuzzing/configs/model_config.yaml.
Архитектура за минуту
Прежде чем переходить к интересным частям, полезно понять, как связаны между собой компоненты. Здесь есть три уровня:
- Шелл-драйвер (run_fuzzing.sh), который объединяет этапы конвейера в единую цепочку.
- Набор YAML-файлов рабочих процессов, по одному на каждый этап, которые по сути являются промптами, указывающими агенту LLM, что делать на каждом шаге.
- Набор инструментов MCP, которые агент вызывает для выполнения реальной работы: запуск AFL, компиляция обертки, сохранение сбоя, чтение отчета о покрытии и так далее.
Главное правило проектирования, которого я придерживался, — это четкое разделение ответственности: агент LLM принимает решения, а инструменты MCP отвечают за выполнение. Агент решает, что фаззить, какую обертку написать и какой пробел в покрытии исследовать дальше. Инструменты предоставляют лишь примитивы вроде run_afl_for или compile_harness. Агент никогда не вызывает AFL или clang напрямую; он собирает конвейер из этих строительных блоков. Все состояние хранится в базе данных SQLite (fuzz_context.db), поэтому этапы не передают данные друг другу в памяти — только через базу данных.
Одна небольшая, но важная деталь: каждая обертка собирается дважды. Инструментирование ребер AFL отлично подходит для направления фаззера, но бесполезно для читаемых человеком отчетов о покрытии. Поэтому каждая обертка становится одновременно двоичным файлом .afl (собранным с помощью afl-clang-lto -fsanitize=address,undefined) и двоичным файлом .cov (собранным с помощью clang -fprofile-instr-generate -fcoverage-mapping). Двоичный файл .afl выполняет фаззинг; двоичный файл .cov впоследствии воспроизводит очередь AFL для получения реального покрытия строк исходного кода и ветвлений.
Цикл обратной связи по покрытию
Это сердце всего конвейера и та часть, которая наиболее непосредственно автоматизирует ручной рабочий процесс, описанный мной в начале.
Если вы когда-либо пытались улучшить покрытие фаззингом вручную, вы знаете, что это итеративный процесс, который выглядит следующим образом:
Шаг «проверить покрытие» раньше выполнялся мной вручную: я просматривал отчет LCOV в поисках непокрытых ветвлений. Шаг «улучшить покрытие» также выполнялся мной — в этот раз путем написания новой обертки или создания нового входного файла. Fuzzing Taskflow передает оба этих шага агенту.
На каждой итерации для каждой обертки агент запускает AFL в течение заданного времени, воспроизводит очередь для двоичного файла .cov, чтобы получить реальный отчет о покрытии, а затем читает список непокрытых ветвлений. На основе полученных данных он выбирает одно из нескольких действий:
- Добавить новый сид, созданный для достижения непокрытого ветвления.
- Отредактировать исходный код обертки для вызова дополнительного API.
- Автоматически обогатить словарь AFL магическими константами, с которыми сравнивается проверка.
- Просто пропустить пробел, если это редкий путь ошибки или сторонний код, который не стоит исследовать.
Временные интервалы удваиваются на каждой итерации:
30с → 60с → 120с → 240с → 480с → 960с (≈ 32 мин/цель)
Идея заключается в том, чтобы тратить дешевые короткие раунды в начале (когда есть много легкодоступного покрытия) и более длинные раунды позже (когда фаззеру требуется больше времени, чтобы преодолеть сложную защиту).
И точно так же, как в моем ручном рабочем процессе, мне нужен ответ на вопрос: когда мы останавливаемся? Здесь цикл использует обнаружение плато: как только две итерации подряд дают прирост меньше настраиваемого порога (по умолчанию 1% абсолютного покрытия строк), цикл решает, что достигнута зона убывающей отдачи, и переходит дальше. Это мешает агенту тратить часы вычислений на выжимание последних долей процента.
Структурно-зависимый фаззинг
Стандартные мутаторы байтового уровня AFL (побитовые инверсии, арифметика, спликшинг блоков) отлично работают с бинарными форматами, но с трудом справляются со структурированными текстовыми вводами. Классическое решение заключается в написании пользовательских мутаторов вручную для каждого формата, что является утомительной работой. На этот раз я хочу, чтобы конвейер сделал эту работу за меня, поэтому в него встроены четыре взаимодополняющих механизма для создания структурно-зависимых вводов.
1. Словари для конкретных форматов и пользовательские мутаторы. Для целей, чей формат ввода распознан (JSON, XML, регулярные выражения, PNG, бинарный TLV с префиксом длины), рабочий процесс поставляется с предварительно созданными словарями AFL и C-файлами LLVMFuzzerCustomMutator. Мутатор JSON выполняет спликшинг токенов и дублирование сбалансированных скобок; мутатор XML знает о тегах, сущностях и атаках миллиарда смехов (billion-laughs); мутатор регулярных выражений содержит реальные паттерны ReDoS. Каждый мутатор делегирует половину своих мутаций обратному стандартному байтовому мутатору AFL, поэтому мы сохраняем рандомизацию движка, а не боремся с ней.
2. Словарь на уровне исходного кода. Для форматов, которые конвейер не распознает, он «на лету» генерирует собственный мутатор, сканируя собственные файлы .c/.h целевого объекта. Он извлекает строковые литералы и 32-битные числовые константы (из #define, case и enum), отфильтровывает шум и использует их в качестве токенов для сплайсинга. Интуиция проста: самые интересные магические значения, которые проверяет парсер, обычно где-то записаны в его собственных исходниках.
3. Динамически генерируемый словарь AFL с обогащением на основе покрытия. Тот же набор исходных токенов также выводится в виде классического словаря AFL перед первой итерацией (числовые константы в обоих вариантах порядка байтов, чтобы фаззер мог удовлетворить memcmp с 4-байтным магическим числом независимо от порядка байтов хоста). Затем, после каждого шага покрытия, конвейер анализирует проверки (guards) рядом с непокрытыми строками (strncmp, memcmp, case 0xN, == ‘X’) и добавляет любые новые найденные токены. Словарь буквально разрастается в сторону кода, до которого фаззер еще не может добраться.
4. Оператор сплайсинга корпусов. Умный мутатор также может загружать файлы из каталога корпуса и внедрять их случайные подрегионы во входные данные — оператор в стиле рекомбинации, с которым стандартный хаос (havoc) AFL справляется плохо.
Эволюция корпуса
Одна из вещeй, которые незаметно убивают эффективность фаззинга, — это выбрасывание прогресса. Если каждый запуск начинается с исходных сидов, вы снова платите цену за повторное открытие одних и тех же путей.
Чтобы избежать этого, для каждого обвязочного модуля (harness) создается стабильный каталог корпуса, который сохраняется между итерациями и целыми кампаниями:
В конце каждой итерации очередь AFL объединяется в этот каталог и прогоняется через afl-cmin для ограничения его размера. В результате интересные входные данные вчерашнего дня переносятся в сегодняшний запуск, а данные, найденные в кампании на прошлой неделе, переносятся в эту. Если вы остановите и перезапустите кампанию, вы ничего не потеряете.
Триаж и отчеты об уязвимостях
Обнаружение сбоя — это только половина дела. Как знает любой, кто занимался анализом первопричин, триаж часто является самой утомительной частью всего процесса. Это еще одна область, где агент проявляет себя наилучшим образом.
После завершения цикла фаззинга автоматически выполняются три этапа. Во-первых, каждый сбой минимизируется с помощью afl-tmin, воспроизводится под ASan для захвата трассировки стека и дедуплицируется по хешу вершины стека (верхние нормализованные фреймы с удаленными шаблонами, пространствами имен встраивания и суффиксами LTO, чтобы семантически идентичные сбои объединялись вместе). Во-вторых, ранее известные сбои воспроизводятся на текущем бинарном файле, чтобы проверить, не устранил ли их вышестоящий патч. В-третьих, агент читает исходный код обвязки и функцию, вызвавшую сбой, отслеживает цепочку вызовов назад от публичного API и пишет отчет в формате Markdown для каждого сбоя.
Каждому отчету присваивается один из следующих вердиктов:
- vulnerability
- library_hardening
- harness_bug
- OOM
- timeout
- assertion_failure
- duplicate
Различие между реальной уязвимостью (достижимой и эксплуатируемой через публичный API) и простой harness_bug (ошибка находится в нашей собственной обвязке, а не в библиотеке) — это как раз тот случай, когда требуется экспертная оценка, которая раньше заставляла меня садиться и вручную трассировать код. Каждый отчет включает в себя анализ первопричин со ссылками на файл и строку, обоснование достижимости, оценку возможности эксплуатации, предлагаемое исправление в виде унифицированного дифа и набросок регрессионного теста.
Просто для ясности: предлагаемые патчи помечены как «требуется проверка» не просто так. Анализ агента ограничен пониманием целевого кода моделью, и он действительно ошибается. Воспринимайте вердикты как очень хорошо подготовленную отправную точку для человека, а не как конечный результат.
Живая панель мониторинга
Проводить автономную кампанию и не иметь возможности видеть, что она делает, неудобно, поэтому конвейер публикует все на интерактивную HTML-панель мониторинга. Она автоматически запускается в фоновом режиме сразу после запуска кампании на порту 8765. В Codespace этот порт перенаправляется автоматически, так что вы можете открыть его в любом браузере и наблюдать за ходом кампании в реальном времени на панели мониторинга.
На странице отображается следующее:
- пульс «работы» для каждого обвязочного модуля
- таблица трендов покрытия с встроенными мини-графиками (sparklines)
- тепловая карта сбоев
- хронология итераций
Заключение
Я начал этот проект, мотивированный ограничениями, которые хорошо известны любому исследователю безопасности: фаззинг работает, но он не масштабируется без внимания человека, и именно человеческое внимание является узким местом. Fuzzing Taskflow — это моя попытка отодвинуть это узкое место назад, переложив рутинные части (написание обвязок, чтение покрытия, поиск пробелов, триаж сбоев) на агента LLM, сохранив при этом четкое разделение между суждениями агента и инструментами, которые выполняют реальную работу.
Если вы являетесь сопровождающим проекта на C/C++, пожалуйста, попробуйте его. Если ваш проект никогда раньше не подвергался фаззингу, этот инструмент поможет вам быстро начать работу. Или, если ваш проект уже проходил фаззинг, этот инструмент может помочь найти новые ошибки за счет увеличения покрытия фаззингом.
Исходный код является открытым, поэтому, пожалуйста, создайте задачу (issue), если вы столкнетесь с какими-либо ошибками. Вклад в проект также приветствуется!