
Новое исследование: 65–75% рабочих патчей от передовых ИИ-агентов воскрешают уязвимости, которые уже были найдены, исправлены и преданы забвению.
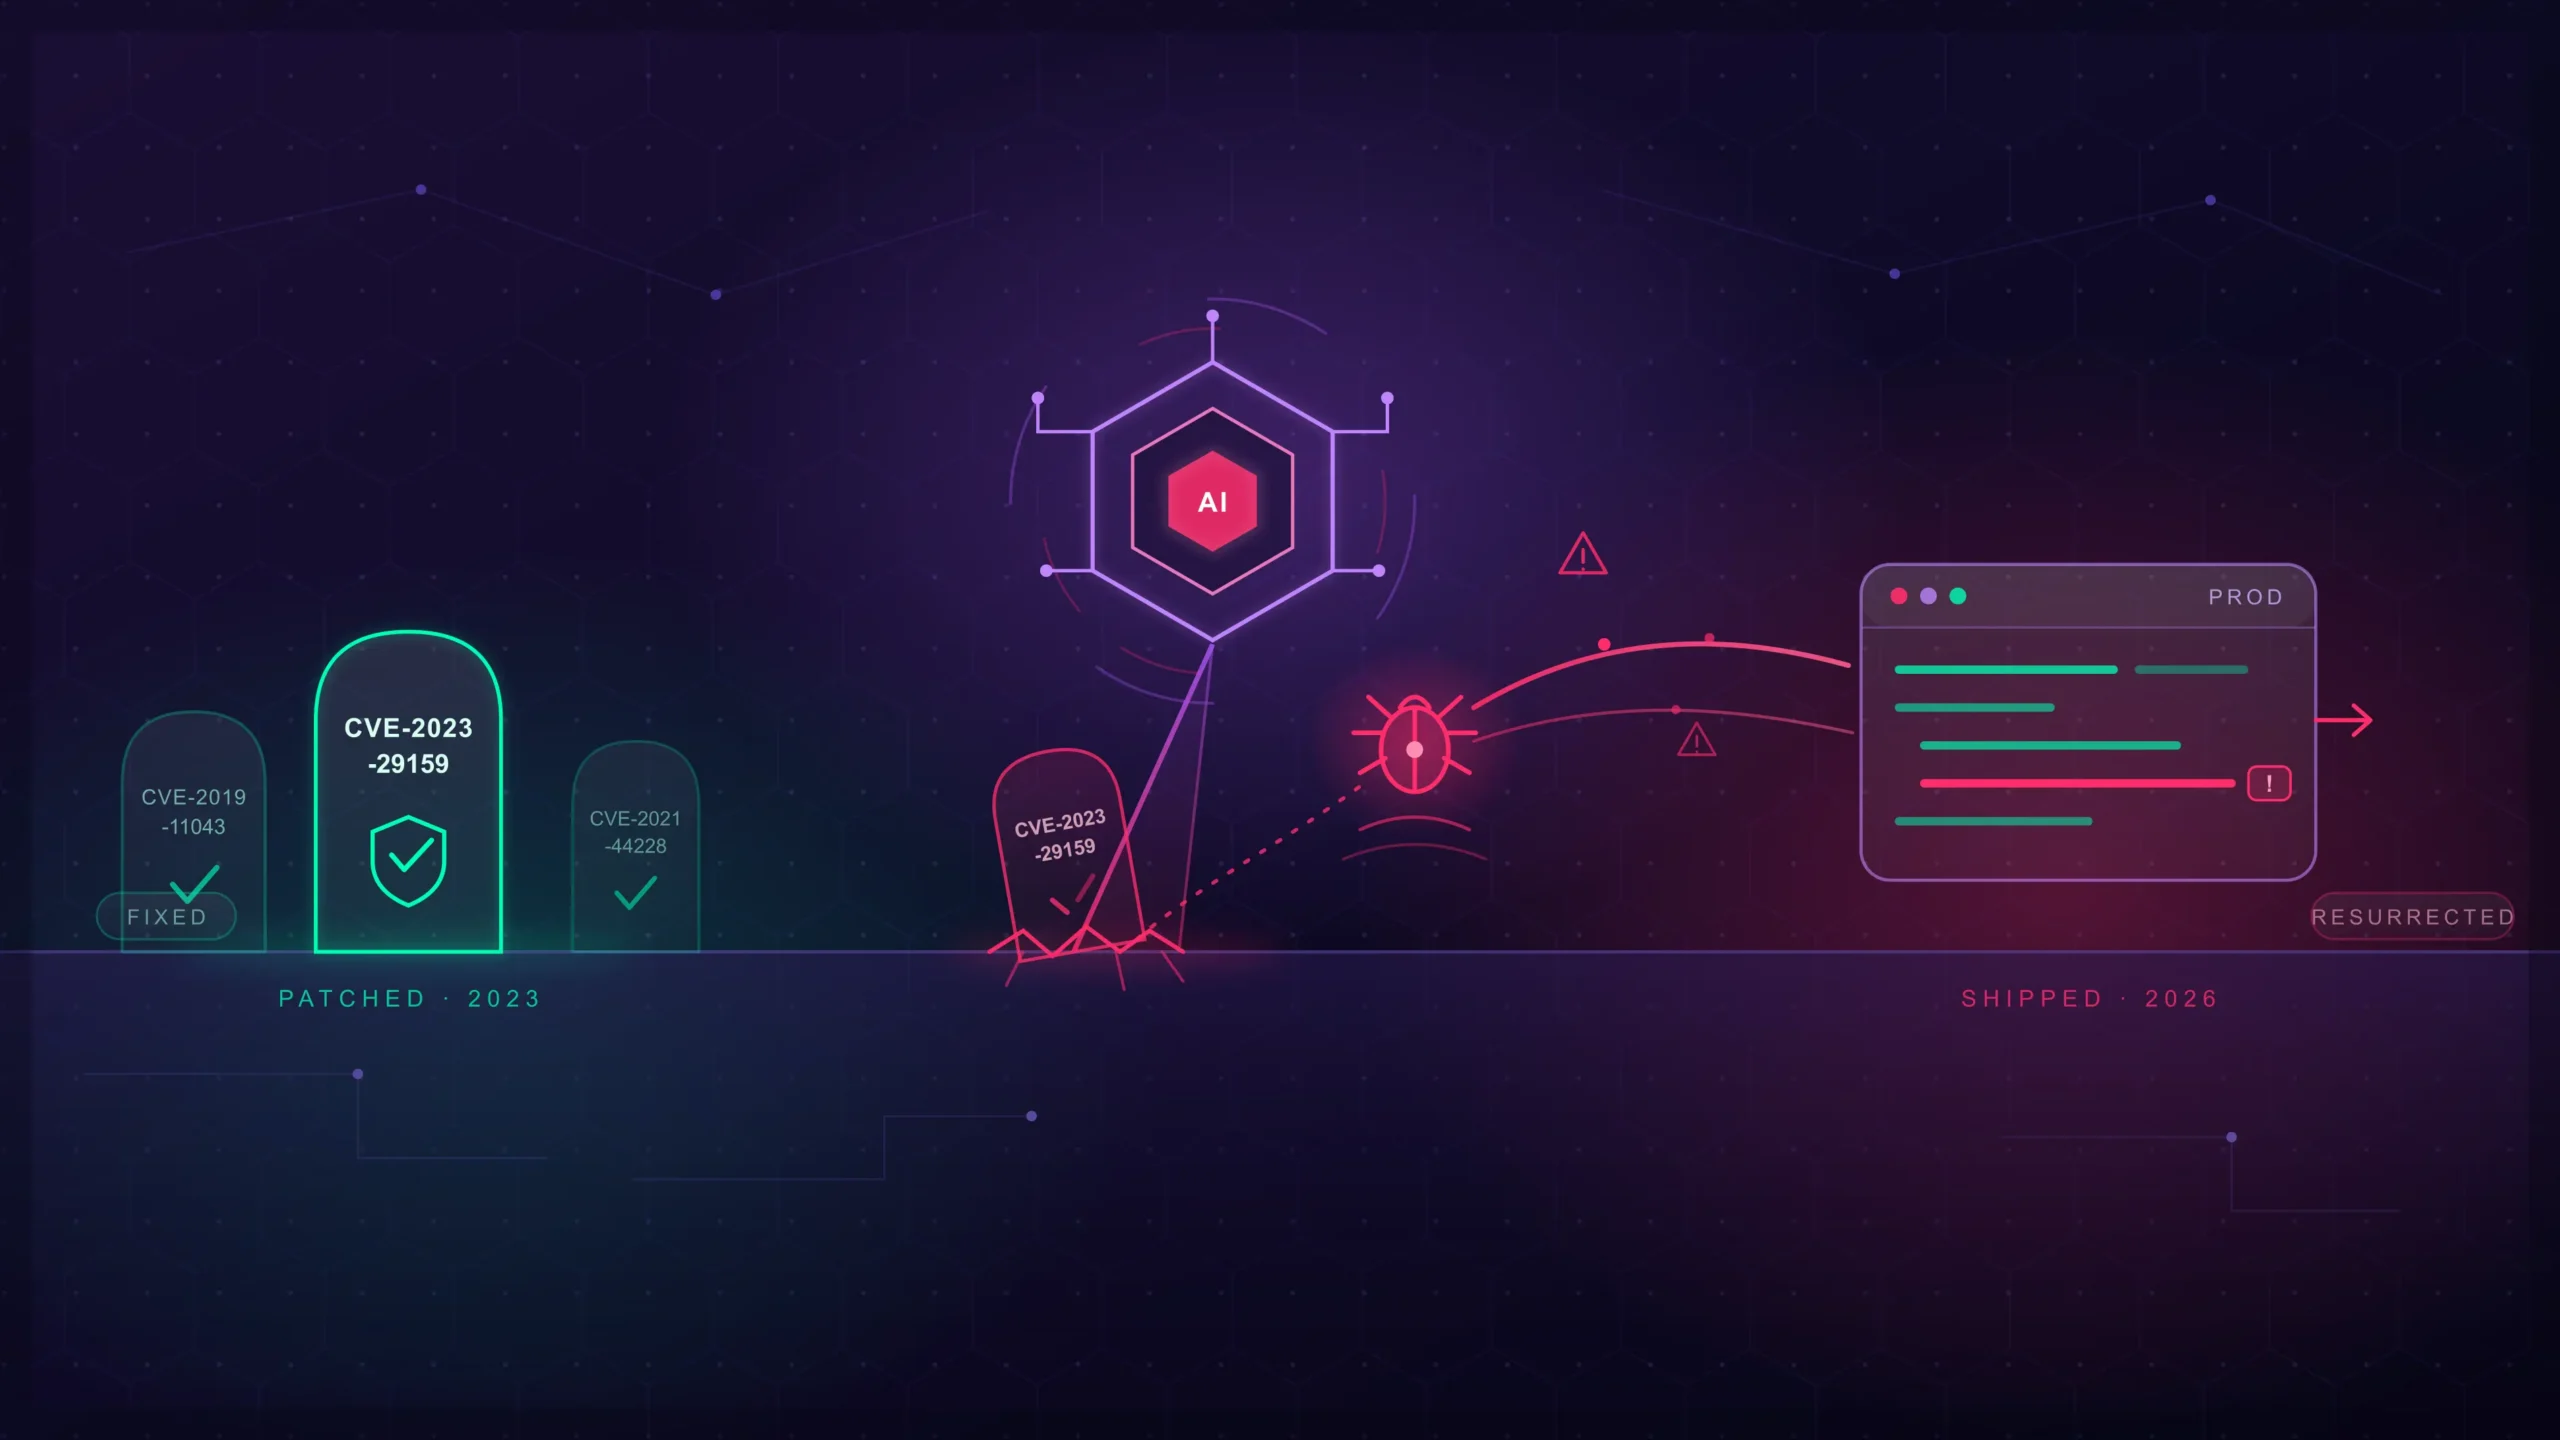
В 2023 году в Starlette, одном из самых популярных веб-фреймворков Python, была обнаружена уязвимость обхода пути (path traversal), зарегистрированная как CVE-2023-29159, и исправлена. Дело закрыто. Ошибка была мертва и похоронена, как и сотни тысяч CVE до нее: обнаружена исследователями, исправлена мейнтейнерами и предана забвению благодаря кропотливой работе сообщества безопасности.
В 2026 году передовой ИИ-агент для написания кода переписал ту же самую функцию. Уязвимость буквально восстала из мертвых. И это был не единичный случай.
Это один из главных выводов нового независимого исследования, заказанного Checkmarx у Ильи Кабанова, генерального директора The Weather Report. Это первое исследование, которое измеряет, из поколения в поколение, становится ли ИИ-код безопаснее по мере того, как он становится лучше.
Ответ — нет. На самом деле, по иронии судьбы, все как раз наоборот.
Похоже, безопасность просто не является критерием в гонке вооружений ИИ-агентов за все большими возможностями. Результатом является ИИ-вывод, который в самом важном аспекте становится все менее безопасным: поколение назад большинство небезопасных попыток даже не работали, поэтому они никогда не попадали в продакшн. Теперь почти все работает, все отправляется в продакшн, и, согласно исследованию, 65–75% этого кода спотыкается о те же старые CVE, которые индустрия уже решила, возвращая их обратно в эксплуатацию.
Читать полное исследование
Тест на кладбище
Вместо того чтобы изобретать еще один бенчмарк, в исследовании были повторно запущены два уже существующих на современных передовых моделях: Claude Opus 4.8, GPT-5.5, Gemini 3.1 Pro и Gemini 3.5 Flash, каждая в своем собственном нативном агентском CLI.
Более сложный из двух, SusViBes, по сути является кладбищем: 200 реальных задач по реализации функций внутри крупных репозиториев с открытым исходным кодом, каждая из которых построена вокруг реальной уязвимости, которую человек уже нашел, раскрыл и исправил. Агенту предлагается создать эту функцию. Вопрос в том, придет ли он независимо к защите, которая содержалась в исправлении человека, или снова откопает старую ошибку.
Результаты:
- Функциональный успех вырос до 83–95% по всей группе — по сравнению с 44–61% всего одно поколение моделей назад. Написание рабочего кода практически решено.
- Успех в обеспечении безопасности и функциональности достиг лишь 24–36%. Среди всех моделей 65–75% рабочих патчей воскрешали уязвимость, которую люди уже устранили.
- Разрыв между функциональностью и безопасностью увеличился — в линейке Claude с 38 до 63 пунктов за одно поколение.
Модели знают, но все равно игнорируют
Вот что делает это более тревожным, чем просто пробел в знаниях. Эти CVE публичны. Их бюллетени, коммиты с исправлениями, описания — все это есть в обучающих данных. Модели, по всей вероятности, видели исправления, но все равно воскрешают ошибки.
Аудит сбоев в исследовании делает это утверждение конкретным. В проанализированных сбоях агенты называли именно ту защиту, которая требовалась в их собственной модели угроз, а затем все равно выпускали уязвимый код.
«Просто попросить его быть безопасным» не работает
В исследовании была протестирована лестница все более дорогих вмешательств:
- Напоминание из одной строки «следуйте лучшим практикам безопасности» добавило всего 1–8 пунктов к безопасности, в зависимости от модели.
- Максимальное увеличение усилий на рассуждение добавило ноль безопасности при точечной проверке — и сократило количество рабочих патчей вдвое.
- Специальный этап моделирования угроз перед написанием кода поднял совокупный успех в безопасности и функциональности до 43–49%, при примерно двукратном увеличении стоимости токенов по сравнению с написанием кода в одиночку.
- Добавление постфактум проверки безопасности достигло 47–56% — при примерно 2,5-кратной стоимости токенов.
Даже при оплате модели в несколько раз больше исходной задачи для обеспечения безопасности собственного вывода, примерно половина задач все равно выпускалась небезопасной.
Что это значит для вашего пайплайна
Одно примечание по охвату, о котором исследователи предупреждают, как и мы: эти задачи бенчмарка были выбраны потому, что уязвимость является естественным способом реализации функции. В обычном повседневном коде уровень воскрешения, вероятно, ниже. Но это слабое утешение: реальные кодовые базы полны именно таких функций, потому что именно оттуда изначально и пришли CVE.
И это не ограничивается лабораторией. Собственный отчет Checkmarx «Будущее AppSec 2026» — опрос 2350 CISO, менеджеров по AppSec и разработчиков в 14 странах — подтверждает эти выводы:
- 70% разработчиков говорят, что генерация кода с помощью ИИ создала больше уязвимостей в их коде в 2025 году.
- Код, сгенерированный ИИ, уже способствовал 25% взломов, став одним из четырех главных векторов взлома в первый год отслеживания.
- И кривая «доза-реакция» неоспорима: организации, где 81–100% кода генерируется ИИ, выпускают уязвимый код в 3,4 раза чаще, чем те, у кого этот показатель составляет 1–20%.
Поскольку почти половина (49%) производственного кода сейчас генерируется ИИ, это не один зомби, бродящий из могилы, — это целая орда.
Читать полное исследование
Полный документ, включая разбивку по CWE, анализ стоимости вмешательства и полную таксономию режимов сбоев, доступен здесь:
Читать полное исследование
Теги:
ADLC
Агентный ИИ
исследование безопасности
vibe coding