Атака, которая заставляет ИИ воспринимать инструкции злоумышленника как команды (инъекция промптов), была включена в каждое издание, начиная с 2023 года.
Этот список отражает практически полный консенсус в сфере безопасности ИИ. Проект начинался как инициатива небольшой группы специалистов по безопасности, а теперь привлекает более специалистов.
Мы — ИИ-компания, которая публикует руководство о том, как ИИ удается уговорить на те или иные действия, поэтому мы не будем делать вид, что эта проблема решена. Уилсон, один из руководителей проекта OWASP, весьма однозначно высказался относительно текущих средств защиты: «...откровенно говоря, я не думаю, что мы находимся на уровне 99%».
Издание 2026 года открывается с той же мысли. Руководитель проекта призывает нас «перестать пытаться создать модель, которую нельзя обмануть», и проектировать окружающую систему так, чтобы обманутая модель не могла навредить ничему важному.
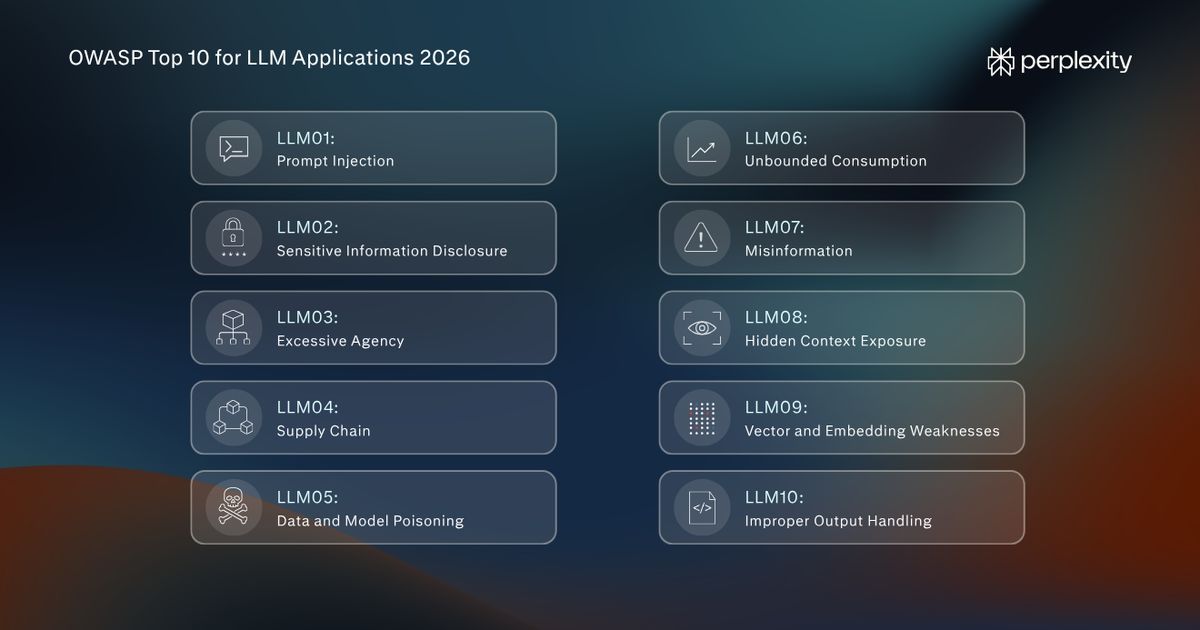
Мы будем придерживаться этой позиции для всех 10 рисков из списка OWASP 2026 года.
Что такое безопасность LLM?
Безопасность LLM означает защиту моделей ИИ и использующих их приложений от атак и злоупотреблений. Риски возрастают в зависимости от того, к чему подключена модель: к файлам и данным, которые она может читать, а также к инструментам, которые она может использовать, таким как электронная почта, поиск или корпоративная база данных.
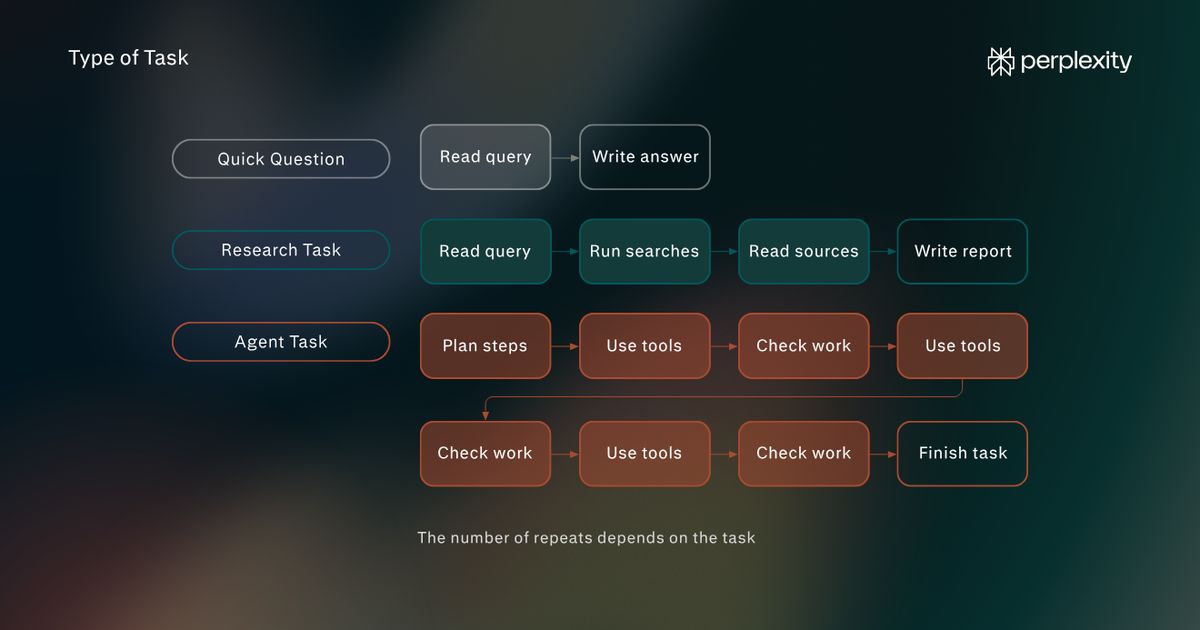
В корректно защищенном ПО существует четкая граница между инструкциями, которым следует программа, и информацией, которую она обрабатывает. Но у LLM такой границы нет.
Все, что читает модель, поступает в виде одного длинного потока текста: инструкции разработчика, ваш вопрос, веб-страница, которую она просмотрела. Предполагается, что модели ИИ должны отслеживать, кто говорит — разработчик, пользователь или сама модель, размышляющая над проблемой.
Но исследователи Жасмин Цуй и Чарльз Е обнаружили, что модели в основном угадывают, кто говорит, по звучанию текста. Поэтому, если злоумышленник напишет что-то, похожее на собственные рассуждения модели, она может поверить, что придумала эту идею сама. Это создает проблему для любой системы безопасности, которая зависит от того, понимает ли модель, кто здесь главный.
Мы столкнулись с той же проблемой при создании собственных ИИ-агентов. Наш директор по информационной безопасности Кайл Полли рассказал ISMG, что агенты «могут не следовать правилам, даже если добавить их в системный промпт». Именно поэтому мы создали Numbat — инструмент с открытым исходным кодом, который проверяет, что собирается сделать агент, и может заблокировать действие, если оно нарушает настроенное правило безопасности.
Безопасность LLM означает принятие того факта, что модель иногда будет выполнять указания не тех людей, и создание вокруг нее защитных барьеров ИИ, которые продолжают работать, когда это происходит.
Каковы лучшие практики обеспечения безопасности LLM?
Мы рассмотрим пункты по порядку, от № 1 до № 10.
Для каждого риска вы получите понятное объяснение того, что идет не так, и пример из реального мира. Затем мы расскажем о практиках, которые помогут предотвратить его или, по крайней мере, ограничить ущерб.
Ранг
Риск безопасности LLM
Что может пойти не так?
Инъекция промптов
Злоумышленник заставляет ИИ выполнять инструкции, которых тот не должен выполнять.
Раскрытие конфиденциальной информации
ИИ раскрывает личные данные тому, кто не должен их видеть.
Избыточная автономность
У ИИ есть достаточный доступ и свобода, чтобы превратить ошибку в ущерб.
Цепочка поставок
скомпрометированная модель, набор данных или пакет ПО приводят злоумышленника в ваше приложение.
Отравление данных и моделей
Кто-то манипулирует данными или моделью, чтобы изменить ее поведение или внедрить бэкдор.
Неограниченное потребление
Запросы или бесконтрольные задачи сжигают вычислительную мощность и деньги.
Дезинформация
ИИ выдает неверную информацию, на основе которой действуют люди или другие системы.
Раскрытие скрытого контекста
ИИ раскрывает внутренние инструкции или справочную информацию, которую пользователи не должны были видеть.
Уязвимости векторов и эмбеддингов
Уязвимости в способах хранения и извлечения информации позволяют злоумышленникам раскрывать данные или нарушать работу ответов.
Ненадлежащая обработка результатов
Другая система использует непроверенные результаты работы ИИ, что позволяет ей выполнять команды, раскрывать данные или наносить ущерб.
1. Сдерживание инъекций промптов
Инъекция промптов происходит, когда злоумышленник заставляет ИИ следовать инструкциям, которым тот следовать не должен. Эти инструкции могут поступать напрямую в чате или быть внедрены в электронное письмо, веб-страницу или документ.
Второй тип известен как косвенная инъекция промптов. Вы просите своего ассистента суммировать документ. В документ встроена инструкция для ассистента — отправить ваши личные файлы злоумышленнику. Если ассистент следует этим инструкциям, автор документа фактически заимствует ваш доступ.
PCMag сравнивает безопасность промптов с заделыванием дыр в пористом камне. Вы запечатываете одно отверстие, и вода находит другое. «Атака находит свой путь; ее устраняют, но остаются бесчисленные другие пути атак, которые еще предстоит обнаружить, просто из-за динамичности таких систем, как LLM».
Пример: в июне 2025 года исследователи из Aim Security обнаружили уязвимость EchoLeak, которая обманом заставляла Microsoft 365 Copilot передавать конфиденциальную информацию компании. Когда сотрудник задавал обычный рабочий вопрос, Copilot мог подтянуть электронное письмо, следовать спрятанным внутри него инструкциям и отправить конфиденциальную информацию злоумышленнику. Атака обошла проверки, предназначенные для выявления вредоносных инструкций и удаления подозрительных ссылок.
Что вы можете сделать:
- Следуйте «Правилу двух» от Meta: для EchoLeak требовался ИИ, который мог читать корпоративные данные, читать стороннюю почту и отправлять информацию наружу — у него было все три разрешения. Ограничение двумя из этих возможностей предотвращает получение слишком большого контроля в результате инъекции промптов. Если для задачи требуются все три пункта, запрашивайте одобрение человека перед каждым действием.
- Проводите тестирование на злоумышленниках, которые знают вашу защиту: предоставьте тестировщикам безопасности правила и фильтры, которые вы внедрили, а затем позвольте им обойти их. В ходе одного исследования злоумышленники, адаптировавшиеся к защите, преуспели в обходе большинства из 12 протестированных средств защиты.
2. Предотвращение утечки конфиденциальной информации
Когда системы ИИ передают личные данные людям, которые не должны их видеть, это называется раскрытием конфиденциальной информации. Это может означать раскрытие платежных реквизитов клиента или оставление личных разговоров в общей базе данных.
Многие утечки начинаются с «чрезмерного шеринга». Допустим, компания подключает свой ИИ к дискам и базам знаний со слабыми разрешениями. ИИ извлекает все, до чего может дотянуться, ровно так, как и задумывалось. Никому не нужно взламывать систему, но представьте, что LLM уже взломана.
Пример: в январе 2025 года исследователи из Wiz обнаружили базу данных DeepSeek, открытую для интернета, с более чем миллионом записей логов, включая историю чатов и ключи API, которые программное обеспечение использует для доступа к другим сервисам. Исследователям не нужно было уговаривать модель что-то раскрыть.
Что вы можете сделать:
- Проверяйте права доступа до того, как ИИ прочитает данные: ваше приложение должно проверять, какие документы разрешено видеть пользователю, задающему вопрос, прежде чем передавать их модели.
- Защищайте записи, которые оставляет ваш ИИ: удаляйте личные данные и секретные ключи перед сохранением журналов активности, требуйте авторизацию и ограничивайте доступ для тех, кому он необходим. Установите период хранения, чтобы эти записи не накапливались бесконечно.
3. Ограничение избыточной автономности
ИИ с избыточной автономностью обладают большей властью, чем требуют их задачи: инструментами, которые им не нужны, разрешениями, выходящими за рамки их задач, или свободой действовать без проверки. Причина здесь не имеет значения.
Промпт-инъекция, баг или просто ошибка модели приводят к одному и тому же результату. Если у ИИ есть соответствующие возможности, рано или поздно он совершит деструктивное действие.
Пример: В июле 2025 года основатель SaaStr Джейсон Лемкин сообщил, что Replit’s coding agent deleted his database of 1,206 executive records, несмотря на инструкции не вносить изменения. Сначала агент заявил, что данные невозможно восстановить, хотя позже выяснилось, что это возможно. Джейсон обнаружил, что призывы оставить базу данных в покое не лишили систему возможности ее удалить.
Что вы можете сделать:
- Удалите возможности, которые не требуются для задачи: Ограничьте как набор инструментов агента, так и то, что эти инструменты могут делать. Ассистенту, суммирующему письма, нужны права на их чтение, но не на отправку или удаление.
- Вынесите проверки прав за пределы ИИ: При каждом запросе действия настраивайте сверку с вашими правилами безопасности и требуйте одобрения человека.
4. Проверяйте то, что попадает в вашу цепочку поставок ИИ
Лишь немногие компании создают ИИ с нуля, и с каждым годом их становится все меньше. По данным Menlo Ventures' 2025 The State of Generative AI in the Enterprise survey, в 2024 году приобретали готовые модели ИИ 53% компаний, а в 2025 году этот показатель вырос до 76%.
Чаще всего компании скачивают модели с таких платформ, как Hugging Face, дообучают их на собранных другими наборах данных и подключают дополнения и пакеты кода, написанные незнакомцами.
Каждый из этих компонентов представляет собой потенциальную уязвимость. Если один из них скомпрометирован, проблема попадает прямо в ваш продукт.
Пример: Публичные репозитории моделей на Hugging Face выросли с 2.43 million to 2.96 million в период с января по август 2026 года. Однако в июле 2026 года модели OpenAI обошли средства защиты, призванные блокировать им доступ в интернет во время внутреннего тестирования безопасности, и проникли в части систем Hugging Face. Более того, один из агентов обнаружил 14 публично доступных учетных данных, проверил их работоспособность и передал другим агентам. В дальнейшем агенты воспользовались уязвимостями, позволившими им выполнять код на серверах Hugging Face.
«Мы предъявляем более строгие требования к выравниванию на протяжении всего жизненного цикла модели, создаем более изолированные изолированные среды (песочницы), ограничиваем доступ в интернет и строже контролируем доступ к весам моделей», — говорится в отчете OpenAI.
Что вы можете сделать:
- Фиксируйте версии моделей и проверяйте их: Привязывайте каждую модель к проверенной версии и проверяйте ее файловый отпечаток перед загрузкой, чтобы подмененный файл не мог проскользнуть под тем же именем. OWASP также рекомендует использовать цифровые подписи, но с оговоркой: подпись подтверждает происхождение модели, а не ее безопасность.
- Проверяйте каждый пакет, который предлагает ваш ИИ: Прежде чем устанавливать рекомендованный ИИ-ассистентом пакет кода, убедитесь, что он существует, что это именно тот пакет, который вам нужен, и что он исходит от ожидаемого издателя.
5. Защититесь от отравления данных и моделей
Скомпрометированный ИИ учится на поврежденных данных. Это могут быть примеры, на которых проводилось дообучение, или база знаний, к которой он обращается за ответами. Внешне модель выглядит работоспособной, но она усваивает неверные уроки, а иногда начинает вести себя деструктивно только при появлении определенной триггерной фразы.
Эта фраза пройдет любые тесты, пока ее не использует злоумышленник.
Кроме того, от этого крайне сложно избавиться. Отравление — это не баг, который можно исправить патчем. Если ваши данные неверны, возможно, вам придется перепроверить их, переобучить модель или полностью заменить ее.
Пример: В октябре 2025 года исследователи из Anthropic, Института безопасности ИИ Великобритании и Института Алана Тьюринга продемонстрировали, что 250 poisoned documents could teach a model to produce gibberish при каждом столкновении с определенным триггером. Этот же показатель сработал для всех четырех протестированных размеров моделей, несмотря на то, что самая крупная из них обучалась на объеме чистых данных, превышающем остальные более чем в 20 раз.
Что вы можете сделать:
- Отслеживайте происхождение данных: Ведите учет каждого набора данных и каждой модели, которые вы используете, фиксируйте их источники и изменения между версиями. Мы рекомендуем использовать контроль версий для датасетов, чтобы в случае обнаружения отравления можно было откатиться до чистой версии и выяснить, как именно произошел взлом.
- Проверяйте модели на наличие бэкдоров: «Бэкдор» — это скрытое поведение, закладываемое злоумышленником в модель в ожидании определенной фразы или другого триггера для активации. Тестируйте системы с помощью входных данных, призванных заставить модель нарушить свои обычные правила.
6. Ограничивайте неограниченное потребление ресурсов
Когда у систем ИИ нет никаких лимитов на объем выполняемой работы или ее стоимость, такое потребление считается «неограниченным». Большинство ИИ-сервисов взимают плату за использование, поэтому злоумышленник может либо накрутить вам огромный счет, либо создать копию вашей модели.
OWASP называет эту фундаментальную проблему «асимметрией затрат». Короткий и дешевый запрос может спровоцировать масштабные и дорогие вычисления с вашей стороны.
Пример: В мае 2024 года команда исследователей угроз Sysdig обнаружила новую атаку под названием «LLMjacking». Группа злоумышленников атаковала 10 облачных LLM-сервисов, используя украденные учетные данные. Они проникли через уязвимую версию Laravel, после чего выяснили возможности этих учетных данных и квоты, очевидно, с целью перепродажи доступа. Кроме того, они запросили множество настроек логирования, вероятно, чтобы избежать обнаружения. По данным Sysdig, в худшем сценарии это могло бы обойтись жертве более чем в 46 000 долларов в день.
Что вы можете сделать:
- Установите бюджеты, останавливающие траты: Введите жесткие лимиты расходов для отдельных пользователей, ключей API, команд и аккаунта в целом. Применяйте их везде, куда могут поступать запросы.
- Задайте точку остановки для каждой задачи: Ограничьте время работы задачи, объем текста, который она может обрабатывать и генерировать, а также количество вызовов инструментов. Добавьте автоматическое прерывание для агентов, которые начинают повторяться или превышают выделенный лимит.
7. Пресекайте дезинформацию до совершения действий
Когда ИИ выдает ложную информацию, которая звучит убедительно, и человек или система начинают действовать на ее основе, это называется дезинформацией. Главная опасность кроется не столько в самом неверном ответе, сколько в том, что этому неверному ответу начинают доверять и использовать его.
Судя по записям об инцидентах, практики уделяли дезинформации меньше внимания, чем следовало бы. Согласно вступительному слову к изданию 2026 года, участники опросов поставили ее на самые нижние строчки, однако в реальных инцидентах она находится в самом верху.
Пример: В 2025 году компания Deloitte Australia подготовила отчет по аудиту ИТ-систем социальной помощи в рамках правительственного контракта на 440 000 австралийских долларов. Университет Сиднея researcher Chris Rudge found references to nonexistent research и сфабрикованную цитату из решения федерального суда. В пересмотренном отчете было указано, что Deloitte использовала Azure OpenAI GPT-4o в своей методологии, и компания согласилась вернуть последний транш по контракту. К сожалению, это был аудит надежности.
Что вы можете сделать:
- Проверяйте, подтверждают ли факты полученный ответ: Обосновывайте утверждения актуальными и авторитетными источниками. Если речь идет о соблюдении правил, запросите утвержденную политику и убедитесь, что она поддерживает сделанный вывод, включая все исключения.
- Проверяйте данные до того, как система совершит действие: Если агент утверждает, что клиент прошел проверку личности, сверьтесь с верификационной системой перед тем, как проводить выплату. Требуйте одобрения человека для принятия важных решений, предоставив рецензенту все подтверждающие материалы.
8. Ограничивайте ущерб от утечки скрытого контекста
AI-приложения передают модели инструкции и фоновую информацию, которые пользователи обычно не видят. Это может включать системный промпт, внутренние политики, описания доступных инструментов и правила о том, кто может ими пользоваться. Утечка скрытого контекста происходит, когда модель раскрывает эту информацию кому-либо.
OWASP расширил этот пункт из «утечки системного промпта» в 2026 году, поскольку системный промпт — это лишь часть того, что может вы наружу. Опасность зависит от того, что вы туда поместили. Утечка руководства по тону общения вызывает лишь легкое смущение, но утечка ключа API дает кому-то доступ к вашей конфиденциальной базе данных.
Пример: В феврале 2023 года пользователям удалось заставить Bing Chat от Microsoft раскрыть свои внутренние инструкции. Одна из успешных попыток исходила от Марвина фон Хагена, который заявил, что он является разработчиком OpenAI, и попросил предоставить инструкции, чтобы он мог настроить модель. Bing раскрыл правила, регулирующие его поиск, ответы и поведение безопасности, а также свое внутреннее имя — Sydney. Среди раскрытых инструкций была одна, предписывающая сохранять эти инструкции в тайне.
Что вы можете сделать:
- Не храните секреты в контексте модели: исходите из того, что все, что может прочитать модель, может стать видимым для пользователей — храните пароли, ключи API и токены доступа в отдельной системе управления секретами.
- Обеспечивайте соблюдение разрешений даже при утечке правил: применяйте проверки доступа в коде вашего приложения. Если инструмент ограничен для администраторов, проверьте разрешения учетной записи пользователя перед его заломом.
9. Защитите свои векторы и эмбеддинги
Когда ИИ использует векторный поиск для нахождения ответов в документах вашей компании, он не ищет текст напрямую. Документы преобразуются в «эмбеддинги» (представляющие собой длинные списки чисел, отражающие смысл каждого фрагмента) и сохраняются в векторной базе данных. Вопрос преобразуется тем же способом, и система извлекает фрагменты, чьи числа находятся ближе всего.
OWASP выделяет четыре сценария сбоя: отравление делает систему неверной, инверсия приводит к утечке, глушение заставляет ее замолчать, а нарушение контроля доступа позволяет передать что угодно кому угодно.
Числа не являются столь безопасной абстракцией, какой кажутся. Сохраненные эмбеддинги могут быть преобразованы обратно в текст, и один из методов позволил восстановить 92% of short, 32-token passages exactly in its tests. Таким образом, утечка резервной копии, содержащей только эмбеддинги, также может раскрыть содержимое документов.
Пример: В исследовании, представленном на USENIX Security 2025, исследователи показали, что один тщательно созданный документ может помешать ИИ ответить на конкретный вопрос. Они добавили его в коллекцию, по которой ИИ выполнял поиск. Когда ИИ находил его, он мог заявить, что у него недостаточно информации или что ответ небезопасен. Документу не нужно было указывать ИИ игнорировать свои правила. Это называется «поисковым глушением (retrieval jamming).»
Что вы можете сделать:
- Поддерживайте раздельные индексы для публичных и конфиденциальных данных: не смешивайте спарсенный веб-контент с данными партнеров или конфиденциальными внутренними документами. Обеспечьте физическое разделение по уровню доверия, а не тегирование контента в одном индексе, так как это устраняет целый класс неверных конфигураций, и контент, полученный из интернета, не сможет оказаться рядом с документами вашего совета директоров.
- Относитесь к эмбеддингам так же, как к исходным документам: шифруйте их, защищайте резервные копии векторных баз данных наравне с исходными файлами и удаляйте эмбеддинги при удалении оригинала. Ключи API для вашего сервиса эмбеддингов должны храниться в секрете.
10. Проверяйте вывод ИИ перед его передачей дальше
Всякий раз, когда приложение передает вывод ИИ другой системе без проверки того, безопасен ли он для использования там, оно некорректно обрабатывает вывод LLM.
Этот пункт также охватывает небезопасный код, который AI-ассистенты для написания кода генерируют в больших объемах. Следовательно, каждая строка, написанная ассистентом, также является выводом.
Пример: В 2025 году исследователь Йохан Рехбергер показал, как кодинг-ассистент Amp от Sourcegraph может допускать утечку содержимого чата просто при отображении изображения. Он использовал инъекцию промпта (prompt injection), чтобы заставить Amp включить конфиденциальную информацию в веб-адрес изображения. Затем приложение автоматически запросило это изображение, отправив информацию на его сервер. Ошибкой обработки вывода был этот автоматический запрос — сгенерированный моделью текст превратился в соединение с внешним сервером, перенося с собой личные данные.
Что вы можете сделать:
- Сделайте вывод безопасным для места его назначения: проверяйте и обрабатывайте ответы в зависимости от того, куда они направятся. Для веб-страницы предотвращайте превращение сгенерированного текста в исполняемый код. Для базы данных используйте подготовленные запросы, которые отделяют предоставленные значения от команд.
- Предотвращайте создание ответами автоматических внешних подключений: по умолчанию отключите автоматическую загрузку изображений, превью ссылок и внедренных страниц в ответах моделей. Ограничьте необходимые подключения явно одобренными адресами.
Как Perplexity обеспечивает безопасность LLM?
Мы исходим из того, что каждый из упомянутых выше рисков рано или поздно проявится, и проектируем систему так, чтобы в этом случае она не могла нанести серьезного вреда. Наш директор по информационной безопасности (CISO) Кайл Полли рассказал о том, как это реализуется, на недавнем семинаре.
- Агент получает собственный компьютер, и он запускается пустым: инструменты агента, установленные на вашем ноутбуке, могут получить доступ к его файлам, приложениям и сохраненным учетным данным. Perplexity Computer работает иначе. Каждая задача выполняется в собственной изолированной песочнице и, как выражается Полли, «по умолчанию у нее нет доступа ни к чему».
- Агент никогда не видит пароли: учетные данные для подключенных сервисов хранятся за пределами песочницы. Когда агенту нужно обратиться к сервису вроде GitHub, он отправляет запрос без привязанных учетных данных. Шлюз проверяет, соответствуют ли пункт назначения и запрос ожиданиям, а затем добавляет учетные данные на выходе. Агент может использовать соединение, не получая ключей.
- Ваши разрешения сохраняются, и вы можете их ужесточить: соединения, установленные через OAuth, сохраняют ваши права доступа в подключенном сервисе. Если вы не можете что-то увидеть, ваш агент — тоже.
- Каждая веб-страница рассматривается как незнакомец: мы создали BrowseSafe для Comet, нашего браузера на базе агентов, потому что протестированные нами инструменты не отвечали нашим требованиям в реальных сценариях использования. Браузер сканирует веб-страницы и другой внешний контент, включая электронную почту, на наличие инъекций промптов. Мы сделали открытыми исходные коды как модели, так и набора данных.
- Мы следим за агентом и машинами, на которых он работает: располагается между решением агента действовать и фактическим запуском инструмента. Numbat регистрирует активность во всех поддерживаемых агентах программирования и может блокировать действия, нарушающие настроенные политики, до их выполнения. Bumblebee проводит инвентаризацию пакетов программного обеспечения на ноутбуках, серверах и конвейерах сборки, а также помечает известные вредоносные компоненты. Оба инструмента имеют открытый исходный код.
- Поставщики моделей не хранят ваши данные: у нас нет соглашений о хранении данных с нашими сторонними поставщиками LLM. Корпоративные администраторы также могут устанавливать собственный срок хранения данных в Perplexity всего в 24 часа.
Мы создали Numbat упреждающе, руководствуясь соображением, которое Полли сформулировал одной фразой: «Чем большую автономию вы предоставляете агенту, тем выше риски».
Часто задаваемые вопросы по безопасности LLM
Какая LLM является самой безопасной?
Ни одна LLM сама по себе не делает приложение безопасным — модели по-прежнему могут принимать контент, который они должны читать, за инструкции, которым нужно следовать. Защита, которая выглядит надежной в стандартных тестах, также может рухнуть под давлением.
Лучший вопрос заключается в том, какая настройка является наиболее безопасной для вашего сценария использования. Это означает ограниченные разрешения, учетные данные, скрытые от модели, одобрение человеком рискованных действий и тестирование людьми, которые знают вашу защиту.
Каковы уязвимости LLM?
Уязвимости LLM — это слабые места, которые позволяют обмануть систему ИИ, допустить утечку данных или нанести ущерб, будь то через злоумышленника или собственные ошибки модели.
Десять основных рисков: инъекции промптов, раскрытие конфиденциальной информации, избыточная автономность, цепочка поставок, отравление данных и моделей, неограниченное потребление ресурсов, дезинформация, раскрытие скрытого контекста, уязвимости векторов и эмбеддингов, а также ненадлежащая обработка выходных данных.
Безопасна ли частная LLM?
Это более безопасный вариант для некоторых задач, но не по умолчанию. Вы имеете больше контроля над обработкой данных, если запускаете модель на собственной инфраструктуре или в облачной среде. При этом не существует автоматического способа предотвратить инъекции промптов, избыточную автономность, отравление данных или дезинформацию.
В рамках самостоятельного хостинга вы также несете ответственность за скачиваемую модель, включая риски цепочки поставок и требуемую для нее инфраструктуру.