Детекторы ИИ ищут статистические закономерности, артефакты на уровне сигналов, встроенные маркеры и несоответствия, которые могут указывать на то, что контент был создан или изменен с помощью искусственного интеллекта.
Для текста такими сигналами могут быть необычно предсказуемый выбор слов, повторяющиеся структуры или стилистические паттерны. Детекторы изображений, видео и аудио исследуют другие доказательства, такие как частотные артефакты, несоответствия между кадрами, сигнатуры синтетической речи или отсутствие характеристик камеры и записи.
Однако детекторы не «видят» напрямую, что что-то создал ИИ. Они вычисляют, насколько файл похож на примеры аутентичного или синтетического контента, встреченные во время разработки.
В исследовании была обнаружена общая точность обнаружения дипфейков человеком на уровне 55,54%, при этом доверительные интервалы пересекают показатели случайного угадывания. Более поздние исследования подтверждают необходимость рассматривать способность к обнаружению как зависящую от контекста.
Работа, сфокусированная конкретно на дипфейках лиц, охватившая 36 исследований и 13 197 участников, показала точность 56,1%, в то время как исследования вмешательств, включающие обучение или обратную связь, достигли 62,2%.
В этой статье объясняется, что ищут детекторы ИИ в тексте, изображениях, видео и аудио, как работают основные методы обнаружения, что говорят современные исследования о точности и как оценивать детектор, не принимая показатель вероятности за доказательство.
Основные выводы
- Детекторы ИИ ищут закономерности, связанные с созданным или измененным контентом, а не окончательное доказательство авторства.
- Текстовые детекторы могут оценивать предсказуемость токенов, сложность письма, повторы, синтаксис, эмбеддинги и встроенные водяные знаки.
- Детекторы изображений, видео и аудио анализируют пиксели, кадры, частоты, тайминги, шум, метаданные и специфические артефакты генераторов.
- Детектор, который хорошо работает на знакомых эталонных данных, может работать хуже против новых генераторов или реальных медиафайлов.
- Точность сама по себе может скрывать серьезные проблемы ложноположительных или ложноотрицательных результатов.
- Обнаружение работает лучше всего в сочетании с проверкой происхождения, водяными знаками, верификацией источника, контролем личности и проверкой человеком.
Детекторы ИИ ищут измеримые различия между контентом, созданным генеративными системами, и контентом, созданным или записанным с помощью обычных процессов.
Точные доказательства зависят от типа контента:
Разные генераторы оставляют разные паттерны. Эти паттерны могут меняться, когда контент обрезается, перефразируется, переводится, сжимается, фильтруется, записывается с экрана или воспроизводится через одно устройство и записывается через другое.
Обзор 2025 года в Computational Linguistics классифицирует обнаружение ИИ-текста на статистическое обнаружение, нейронное обнаружение, водяные знаки и подходы с участием человека. A 2026 cross-modality surveyаналогично классифицирует детекторы визуальных дипфейков на криминалистические, основанные на данных, основанные на «отпечатках пальцев» и гибридные методы, в то время как аудиодетекторы используют созданные вручную или изученные признаки сигналов.
Как работают детекторы ИИ?
Большинство детекторов ИИ проходят пять основных этапов.
1. Контент подготавливается к анализу
Сначала детектор преобразует представленный контент в формат, который может обработать его модель.
Для текста это может включать разделение отрывка на токены, предложения или числовые эмбеддинги.
Для других медиа детектор может:
- Преобразовать аудио в формы волны или спектрограммы
- Извлечь отдельные кадры видео
- Разделить изображение на фрагменты
- Стандартизировать разрешение или частоту дискретизации
- Разделить аудио- и видеодорожки
- Прочитать метаданные или записи о происхождении
Эта подготовка делает входные данные более согласованными, но при плохой реализации она также может удалить полезные доказательства.
2. Детектор извлекает признаки
Система идентифицирует измеримые характеристики, связанные с аутентичным или синтетическим контентом.
Некоторые признаки выбираются исследователями, например, длина предложения, шум изображения или спектральная энергия. Другие изучаются автоматически нейронными сетями, обученными на размеченных примерах.
Детектору обычно требуется несколько признаков, потому что одна изолированная улика редко бывает надежной.
3. Модель сравнивает признаки
Извлеченные признаки передаются в статистическую модель, нейронный классификатор или гибридную систему обнаружения.
Модель сравнивает входные данные с паттернами, изученными на аутентичных и сгенерированных образцах. Вместо того чтобы найти один решающий признак, она объединяет несколько сигналов в прогноз.
4. Детектор выдает оценку или метку
Результат может отображаться как:
- Показатель вероятности
- Показатель уверенности
- Метка «сгенерировано ИИ» или «создано человеком»
- Вердикт «реально или подделка»
- Подозрительные предложения
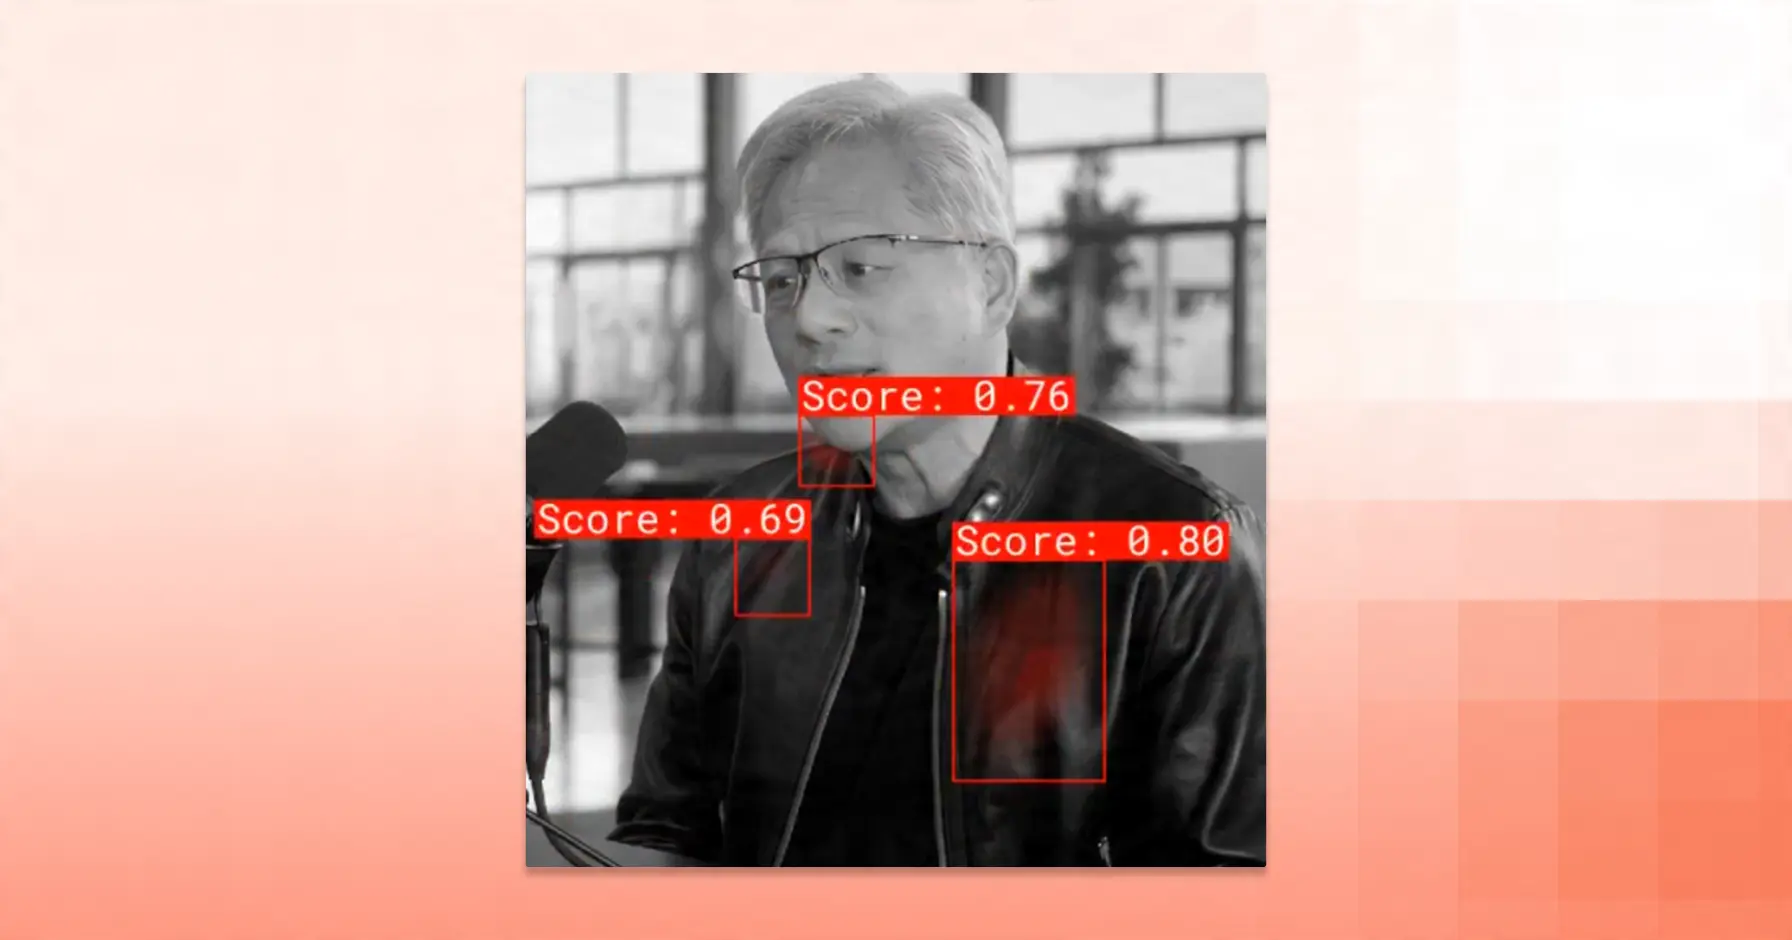
- Выделенные области изображения
- Отмеченные аудиосегменты
- Подозрительные кадры видео
- Объяснение обнаруженных артефактов
Метка зависит от порога детектора. Файл, получивший оценку 0,72, может быть помечен как синтетический при пороге 0,70, но как аутентичный при пороге 0,80.
5. Результат поступает в рабочий процесс принятия решений
Ответственный процесс обнаружения не заканчивается на оценке.
Результат может инициировать:
- Проверку человеком
- Верификацию источника
- Дополнительные проверки личности
- Проверку водяных знаков
- Инспекцию происхождения
- Запрос исходного файла
- Временную приостановку высокорискованного действия
- Анализ другой независимой системой
Этот заключительный этап определяет, станет ли обнаружение полезным сигналом безопасности или ненадежным автоматизированным суждением.
Что ищут детекторы ИИ-текста?
Детекторы ИИ-текста в первую очередь ищут статистические и стилистические закономерности, связанные с выводом больших языковых моделей.
Фраза «детектор ИИ» часто используется в интернете для обозначения детектора ИИ-текста, поэтому понимание обнаружения текста необходимо перед переходом к дипфейк-медиа.
Предсказуемость токенов и перплексия
Большие языковые модели генерируют текст, предсказывая, какой токен, скорее всего, будет следующим.
Детектор может оценить, насколько предсказуемым кажется этот выбор. Одной из связанных метрик является перплексия, которая описывает, насколько неожиданной является последовательность для языковой модели.
Текст с низкой перплексией более строго следует паттернам, которые ожидает модель. Текст с высокой перплексией содержит менее предсказуемый выбор.
Это не означает, что:
- Низкая перплексия доказывает участие ИИ
- Высокая перплексия доказывает авторство человека
- Люди всегда пишут непредсказуемо
- ИИ всегда выбирает наиболее вероятное слово
Четкое техническое письмо, переведенный контент, стандартизированные деловые тексты и тексты, написанные не носителями языка, также могут быть статистически предсказуемыми.
Вариативность предложений и «взрывчатость» (burstiness)
Некоторые детекторы исследуют вариативность в:
- Длине предложений
- Структуре предложений
- Длине абзацев
- Словарном запасе
- Пунктуации
- Грамматической сложности
- Переходах
- Ритме письма
«Взрывчатость» — это неформальный термин, часто используемый для описания изменений в длине или сложности предложений.
Хотя вариативность может способствовать решению детектора, «взрывчатость» не является универсальной метрикой, используемой каждой системой. Ее не следует рассматривать как надежный самостоятельный тест.
Повторы и формульные структуры
Сгенерированные ИИ отрывки могут содержать повторяющиеся идеи, переходы, шаблоны предложений или структуры абзацев.
Детекторы могут изучать такие паттерны, как:
- Повторяющиеся заключительные утверждения
- Одинаковая длина абзацев
- Предсказуемые структуры списков
- Чрезмерно сбалансированные предложения
- Похожая формулировка в разных разделах
- Частые общие переходы
Сами по себе эти сигналы слабы. Люди-авторы используют шаблоны и повторяющуюся терминологию в академических, юридических, технических и корпоративных текстах.
Стилометрические признаки
Стилометрия оценивает стиль письма с помощью таких признаков, как:
- Средняя длина слова
- Лексическое разнообразие
- Использование служебных частей речи
- Части речи и их закономерности
- Читабельность
- Привычки в пунктуации
- Синтаксическая сложность
- Частота специфических конструкций
Классификатор с учителем может выучить комбинации этих признаков на размеченных образцах текстов, написанных людьми и ИИ.
Ограничение заключается в том, что стиль может отражать образование автора, языковую среду, профессию, задачу или процесс редактирования, а не то, был ли задействован ИИ.
Эмбеддинги и нейронная классификация
Некоторые детекторы представляют весь отрывок в виде числового эмбеддинга.
Затем нейронный классификатор оценивает, насколько это представление похоже на образцы, написанные человеком или сгенерированные машиной в его обучающей выборке.
Этот подход позволяет уловить взаимосвязи, которые пропускают простые измерения грамматики или перплексии. Однако он все еще может испытывать трудности, если текст происходит из:
- Модели, отсутствующей в обучающем наборе
- Новой предметной области
- Другого языка
- Сильно отредактированного черновика ИИ
- Необычного стиля письма человека
- Смеси вклада человека и ИИ
Специфические сигнатуры моделей
Детектор может выучить повторяющиеся закономерности, связанные с конкретной языковой моделью или семейством моделей.
Это может дать сильные результаты, когда тестируемый контент исходит от знакомого генератора. Это также может привести к плохой обобщающей способности, когда контент исходит от неизвестной модели или другой стратегии декодирования.
Бенчмарк RAID содержит более 6 миллионов генераций по 11 моделям, восьми доменам, 11 состязательным преобразованиям и четырем стратегиям декодирования. Его оценка восьми детекторов с открытым исходным кодом и четырех с закрытым показала, что производительность может быть нарушена незнакомыми генераторами, вариациями сэмплирования, штрафами за повторы и преобразованным текстом.
Встроенные текстовые водяные знаки
Текстовое нанесение водяных знаков изменяет процесс выбора токенов во время генерации ответа моделью.
Вместо оценки стиля после генерации, детектор проверяет, содержит ли последовательность статистический паттерн, намеренно встроенный генерирующей системой.
Google DeepMind объясняет, что SynthID for text корректирует вероятности токенов для создания незаметного водяного знака. Обнаружение работает лучше на более длинных и разнообразных ответах и может стать менее уверенным после обширного переписывания или перевода. Он также менее эффективен для коротких фактических ответов, где у генератора меньше вариантов допустимых токенов.
Обнаружение водяных знаков отвечает на более узкий вопрос, чем общий классификатор: содержит ли контент совместимый водяной знак, а не могла ли какая-либо система ИИ его создать.
Что исследования показывают о детекторах ИИ-текста
Несколько исследований демонстрируют, почему оценка детектора текста требует контекста.
Современные детекторы ИИ-текста все еще имеют значительные пробелы в надежности
В одном исследовании оценивались семь популярных подходов к обнаружению в ранее не виданных доменах, языковых моделях и стратегиях обхода на основе промптов. В некоторых условиях доля истинно положительных результатов при 1% ложноположительных падала до 0%, показывая, как трудно поддерживать одновременно высокую чувствительность обнаружения и низкий уровень ложноположительных результатов, когда входные данные отличаются от исходных данных оценки детектора.
Другое исследование оценило 12 современных детекторов, используя набор данных из 15 000 образцов человеческого письма, доработанных с разной степенью помощи ИИ. Исследователи обнаружили, что детекторы часто помечали даже минимально отполированный ИИ текст как сгенерированный ИИ и с трудом различали уровни вовлеченности ИИ.
Предвзятость детекторов ИИ-текста варьируется в зависимости от систем и групп авторов
В одном исследовании оценивались 16 систем обнаружения машинописного текста с учетом пола, расы и этнической принадлежности, статуса изучающего английский язык (ELL) и экономического статуса.
Хотя предвзятость была непоследовательной в разных системах, исследователи обнаружили, что эссе ELL чаще классифицировались как машинописные, а эссе не-белых ELL непропорционально чаще классифицировались как машинописные по сравнению с их белыми коллегами.
Однако отдельное исследование, пересматривающее предвзятость к неносителям языка на чешском языке, не обнаружило систематической предвзятости в трех семействах детекторов и установило, что современные детекторы могут работать, не полагаясь на перплексию.
В совокупности эти результаты предполагают, что справедливость должна оцениваться для конкретного детектора, языка, домена и группы пользователей, а не предполагаться на основе одного бенчмарка.
Изменения стиля могут привести к значительной потере производительности
Исследование показало, что текстовые классификаторы очень чувствительны к стилю письма и сложности. В некоторых условиях производительность детектора деградировала до уровня случайного классификатора.
Исследователи также обнаружили тенденцию ошибочно классифицировать более легкий для чтения контент, что усиливает опасения, что простота письма может быть принята за генерацию ИИ.
Результаты бенчмарков не переносятся равномерно
Исследование выявило существенные различия между генераторами и дискриминаторами. Некоторые генераторы обманывали большинство детекторов, в то время как некоторые системы детекторов идентифицировали контент почти всех оцененных генераторов.
Это означает, что утверждения типа «детекторы ИИ работают» или «детекторы ИИ не работают» слишком широки. Производительность зависит от конкретной пары детектор-генератор и условий оценки.
Что ищут детекторы ИИ-изображений?
Детекторы изображений исследуют видимый контент, поведение необработанных пикселей, частотную информацию, метаданные и встроенные сигналы подлинности.
Общие признаки включают:
- Неровности текстуры: кожа, волосы, ткань, листва, отражения или фоны могут содержать повторяющиеся или статистически необычные паттерны.
- Частотные артефакты: генераторы изображений могут оставлять паттерны в пространственных частотах, которые трудно увидеть напрямую.
- Несоответствия шума: изображения, снятые камерой, содержат сенсорный и процессорный шум, который может отличаться от сгенерированного контента.
- Конфликты освещения: тени, отражения, блики и направление света могут не совпадать по всему изображению.
- Геометрические несоответствия: ориентиры лица, границы объектов, перспектива или симметрия могут вести себя необычно.
- Свидетельства локального синтеза: подлинное изображение может содержать меньшую область, созданную с помощью инпейнтинга или генеративного редактирования.
- Отпечатки генератора: специфические архитектуры моделей могут оставлять повторяющиеся статистические паттерны.
- Метаданные: устройство захвата, программное обеспечение, история изменений и временные метки могут помочь в расследовании.
- Водяные знаки: детектор может искать невидимую метку, встроенную участвующим генератором.
- Происхождение контента: система может проверять подписанные записи, описывающие, откуда произошел актив и как он изменился.
Видимые ошибки, такие как искаженные руки, становятся менее полезными по мере улучшения генераторов. Обнаружение все больше зависит от анализа на уровне сигналов, а не от контрольного списка очевидных визуальных ошибок.
Почему обрезка и редактирование имеют значение
Исследование изучило инструмент предварительной проверки водяных знаков Meta для изображений, созданных с помощью Muse Image.
Инструмент успешно проверил все 40 исходных изображений, но не смог верифицировать 55% из них после того, как изображения были обрезаны примерно до одной трети или половины от их первоначального размера.
Это было тестирование встроенного водяного знака Content Seal от Meta, а не всех типов детекторов ИИ-изображений. Оно демонстрирует, что верификация водяных знаков и судебно-медицинская классификация имеют разные режимы сбоев. Сильная обрезка может удалить или ослабить встроенный сигнал, даже если оставшееся изображение все еще является синтетическим.
Что ищут детекторы ИИ-видео?
Видеодетекторы анализируют как отдельные кадры, так и изменения между ними. Они могут искать:
- Границы лица, которые смещаются с течением времени
- Несоответствующие признаки личности
- Неестественные движения глаз, рта или головы
- Движения губ, которые не совпадают с речью
- Изменения текстуры кожи между кадрами
- Некорректно перемещающееся освещение или тени
- Фоновые объекты, которые появляются или исчезают
- Несоответствия в размытии при движении
- Повторяющиеся кадры или временные паттерны
- Различия между аудио- и видеодорожками
- Пространственные или временные артефакты, специфичные для генератора
Один кадр может казаться подлинным, в то время как движение в течение нескольких кадров выявляет манипуляцию.
Поэтому видеодетекция обычно сочетает в себе:
- Пространственный анализ: изучение содержимого каждого кадра
- Временной анализ: изучение согласованности и движения между кадрами
- Аудиовизуальный анализ: сравнение звуков речи с движением губ и сигналами идентификации личности
Реальное видео сложнее, чем чистые эталонные данные
В Deepfake-Eval-2024 benchmark был собран контент из реальных условий, распространенный на 88 веб-сайтах и на 52 языках. Он включал 45 часов видео, 56,5 часов аудио и 1975 изображений.
По сравнению с результатами на более ранних академических тестах, протестированные детекторы с открытым исходным кодом показали снижение AUC на:
- 50% для видео
- 48% для аудио
- 45% для изображений
Исследование не доказывает, что все коммерческие или недавно обученные детекторы теряют столько же. Оно демонстрирует, насколько сильно может измениться производительность, когда системы сталкиваются с актуальным контентом из реального мира, а не со знакомыми лабораторными наборами данных.
Что ищут детекторы ИИ-аудио?
Детекторы аудиодипфейков изучают форму волны, частотный спектр, тайминг и характеристики воспроизведения речи.
Общие сигналы включают:
- Спектральные артефакты: системы синтетической речи могут создавать частотные паттерны, которые отличаются от записанной речи.
- Фазовое поведение: взаимосвязи между компонентами сигнала могут содержать артефакты генерации.
- Отпечатки вокодера: компонент, который преобразует выходные данные модели в аудиоволну, может оставлять повторяющиеся сигнатуры.
- Временная согласованность: характеристики могут неестественно меняться в последовательных аудиосегментах.
- Просодия: ритм, ударение, высота тона, интонация и паузы могут статистически отличаться от подлинной речи.
- Дыхание и звуки рта: естественные неречевые события могут отсутствовать, дублироваться или быть несогласованными.
- Непрерывность фона: комнатный тон или окружающий шум могут неожиданно меняться.
- Сигналы воспроизведения: аудио, воспроизведенное через динамик и записанное снова, содержит акустические характеристики и характеристики устройства, отсутствующие в исходном файле.
- Поведение кодека: сжатие при телефонной связи, конференц-связи, потоковой передаче и в социальных сетях может изменить полезные сигналы детекции.
- Частичная манипуляция: могут быть синтезированы только отдельные слова или части записи.
Человек может слышать естественно звучащую речь, в то время как детектор идентифицирует паттерны в данных о частоте или тайминге. Может произойти и обратное: подлинная, но сжатая, зашумленная или необычная речь может привести к неверному результату.
Что показывает текущий независимый аудио-бенчмарк
Podonos обновил свой бенчмарк детекции аудиодипфейков 2026 года, оценив 23 системы детекции на 4524 аудиоклипах, равномерно распределенных между подлинным и синтетическим аудио.
Бенчмарк включал:
- 23 системы детекции от коммерческих поставщиков и разработчиков моделей с открытыми весами
- Шесть аудиоформатов: MP3, WAV, FLAC, OGG, M4A и WebM
- Подлинное аудио из VCTK, LJSpeech и LibriTTS-360
- Закрытые метки истинности для помощи в снижении настройки бенчмарка
DETECT-World от Resemble AI достигла точности 99,47% с уровнем ложноотрицательных результатов 0,4% и уровнем ложноположительных результатов 0,7% в последней оценке.
Как мультимодальная ИИ-детекция объединяет доказательства
Мультимодальная детекция изучает более одного типа медиа в рамках одного файла или рабочего процесса.
Например, система видеоверификации может анализировать:
- Содержит ли лицо генеративные артефакты
- Содержит ли голос сигналы синтетической речи
- Соответствуют ли движения губ произносимому аудио
- Остается ли одна и та же личность неизменной
- Содержит ли файл достоверное происхождение
- Появляются ли части медиафайла где-то еще в сети
- Был ли контент воспроизведен или внедрен
- Присутствует ли человек физически
Скоординированный дипфейк может сочетать подлинные фоновые кадры, измененное лицо, синтетическую речь и сфабрикованные документы, удостоверяющие личность. Запуск несвязанных детекторов независимо друг от друга может привести к тому, что связь между этими элементами будет упущена.
Поэтому мультимодальная детекция особенно актуальна для проверки личности и KYC, живых встреч, удаленного найма, финансовых одобрений и проверки доказательств.
Какие методы ИИ-детекции используются?
ИИ-детекторы используют разные подходы в зависимости от типа контента и цели развертывания.
Детекция оценивает, содержит ли контент синтетические паттерны. Водяные знаки проверяют наличие намеренно встроенного сигнала. Провенанс подтверждает утверждения о происхождении и истории редактирования.
Насколько точны ИИ-детекторы?
Ответ одним числом здесь невозможен.
Точность зависит от:
- Используемого детектора
- Модальности контента
- Генерирующей модели
- Появлялся ли этот генератор в обучающих данных
- Языка или предметной области
- Длины выборки
- Качества аудио и изображения
- Сжатия и редактирования
- Баланса классов
- Порога принятия решения
- Набора данных бенчмарка
- Является ли тест внутридоменным или внедоменным
- Является ли контент полностью синтетическим или частично отредактированным
Детектор может достичь высоких результатов на одном бенчмарке, но потерпеть неудачу при столкновении с новым генератором, языком, кодеком или трансформацией платформы.
Краткий обзор текущих исследований
Почему точность сама по себе может вводить в заблуждение
Общая точность — это процент правильных классификаций. Она может скрыть то, как именно детектор совершает ошибки.
Представьте, что только 1% отправленных файлов являются синтетическими. Детектор, который помечает каждый файл как подлинный, достигнет точности 99%, не обнаружив при этом ни одного синтетического контента.
Поэтому организациям следует изучать более одной метрики.
Оценка текстового дискриминатора NIST использует метрики, включая AUC, коэффициент равной ошибки, уровень истинно положительных результатов при заданном уровне ложноположительных результатов и байесовский риск. Это отражает, почему стандартизированные оценки не полагаются только на общую точность.
Почему результаты ИИ-детекторов могут быть ошибочными?
Ложноположительные результаты возникают, когда подлинный контент классифицируется как синтетический. Ложноотрицательные результаты возникают, когда сгенерированный или измененный контент классифицируется как подлинный.
Несколько условий могут вызвать эти ошибки.
Генератор не был представлен в обучении
Детектор может распознавать знакомые семейства генераторов, но пропускать артефакты от новой или существенно отличающейся системы.
В этом заключается проблема обобщения: детектор изучил свою среду разработки, не выучив при этом признаки, которые надежно переносятся на будущий контент.
Контент был преобразован
Кадрирование, перефразирование, перевод, сжатие, фильтрация, передискретизация, транскрибирование, скриншоты, запись экрана и повторная запись могут изменить доказательства, которые ожидает детектор.
Многие преобразования являются рутинными, а не злонамеренными. Социальные сети, системы конференц-связи и приложения для обмена сообщениями автоматически обрабатывают загружаемый контент.
Образец слишком короткий
Короткий абзац, односекундный аудиоклип, изображение с низким разрешением или отдельный кадр видео могут не содержать достаточного количества доказательств для стабильного результата.
Google DeepMind отмечает, что их метод маркировки текста работает лучше с более длинными и разнообразными ответами, поскольку короткие фактические ответы предоставляют меньше возможностей для внедрения обнаруживаемого шаблона.
Вклад человека и ИИ смешан
Человек может существенно переработать черновик, созданный ИИ. Настоящая фотография может содержать одну сгенерированную область. В видео могут использоваться аутентичные визуальные эффекты с синтетическим звуком.
Бинарная метка «человек или ИИ» может неточно описывать эти смешанные случаи. Анализ на уровне сегментов или областей более полезен.
Порог не соответствует риску
Снижение порога может помочь выявить больше синтетического контента, но при этом увеличит количество ложноположительных результатов.
Его повышение может уменьшить количество ложных срабатываний, но при этом пропустить больше манипулированного контента.
Не существует универсально правильного порога. Подходящая настройка зависит от стоимости каждой ошибки.
Бенчмарк не является репрезентативным
Детектор, оцененный на чистых эссе на английском языке, может вести себя иначе при работе со студенческими работами, юридическими текстами, публикациями в социальных сетях или переведенным контентом.
Аудиодетектор, оцененный на студийных записях, может вести себя иначе при работе с телефонными кодеками, шумными звонками или воспроизведенным аудио.
Детектор полагается на хрупкий сигнал
Детектор водяных знаков может дать сбой, если водяной знак поврежден. Детектор отпечатков может не сработать против новой модели. Криминалистический детектор может спутать сжатие с манипуляцией.
Вот почему многоуровневая проверка надежнее, чем зависимость от одного сигнала.
Как оценить ИИ-детектор перед развертыванием
Организациям следует оценивать детектор как часть рабочего процесса контроля рисков, а не как самостоятельный процент.
1. Определите решение, которое он будет поддерживать
Уточните, что произойдет после того, как файл будет помечен.
Возможные действия включают:
- Отправку контента рецензенту
- Запрос другого фактора идентификации
- Приостановку платежа
- Эскалацию оповещения о встрече
- Отклонение загруженного файла
- Маркировку публичного контента
- Начало расследования мошенничества
Чем выше последствия, тем сильнее должны быть доказательства и процесс проверки.
2. Создайте репрезентативный тестовый набор
Тестовые данные должны отражать производственные условия, включая:
- Соответствующие языки
- Реальные группы пользователей
- Форматы файлов
- Устройства
- Микрофоны и камеры
- Кодеки
- Фоновый шум
- Уровни сжатия
- Длину контента
- Известные генераторы
- Незнакомые генераторы
- Смешанный контент человека и ИИ
- Частично манипулированные медиа
- Рутинные платформенные преобразования
Демонстрации поставщиков не являются заменой репрезентативного тестирования.
3. Измеряйте оба типа ошибок
Решите, что дороже: ложноположительные или ложноотрицательные результаты. Например:
4. Тестируйте новый и преобразованный контент
- Кадрирование
- Изменение размера
- Шум