
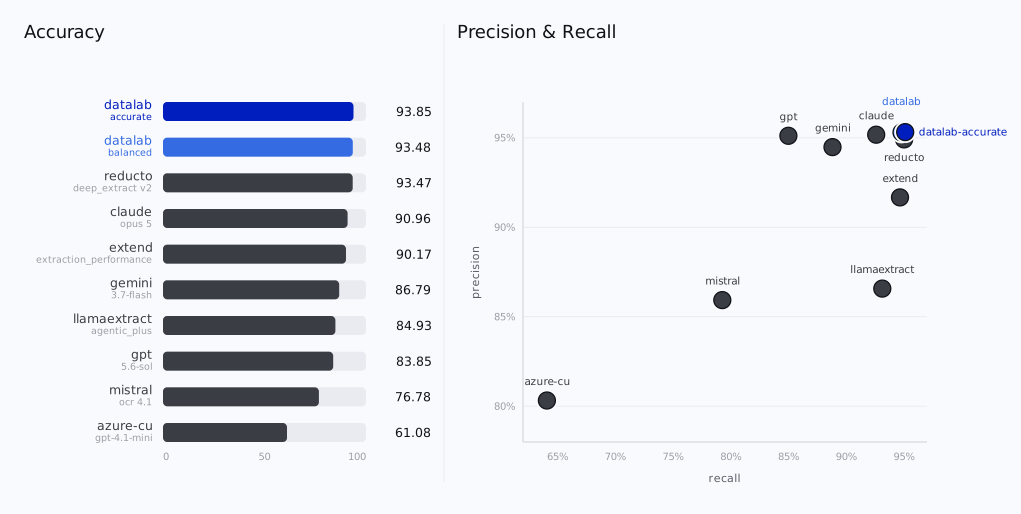
В Datalab мы посвятили себя решению сложной и не самой примечательной задачи: заставить ИИ правильно читать документы без галлюцинаций и ошибок. Извлечение данных из таблиц на тысячи страниц и сложных форм — одна из самых трудных задач в обработке документов. Модель, которая «галлюцинирует» и выдает хотя бы одну неверную цифру в контракте или финансовой отчетности, может нанести реальный ущерб бизнесу.
Мы считаем, что бенчмарк для извлечения данных должен выполнять две функции:
- Помогать клиентам выбирать подходящего поставщика; и
- Предоставлять инженерам способ диагностики того, что именно идет не так в конкретной модели.
Мы следили за всеми недавними запусками бенчмарков, и такие инструменты, как ExtractBench и LongExtractBench, являются полезными отправными точками, но у них есть общие недостатки:
- Документы и система оценки могут быть предвзяты в пользу конкретного поставщика, создавшего бенчмарк;
- Инструментарий для прогнозирования сложно проверить, поэтому невозможно понять, означает ли низкий балл ошибку модели или ошибку самого инструментария;
- Система оценки запутана или сложна для интерпретации, поэтому на вопрос «почему у этого документа низкий балл?» нет внятного ответа; и
- Документы охватывают лишь малую часть всех возможных случаев извлечения данных. Некоторые бенчмарки (например, LongExtractBench) содержат только плотные таблицы. Другие — только чистые документы без сканов. Это не отражает реальный мир и реальные проблемы.
Мы хотели найти справедливый способ оценки вариантов извлечения данных. Поэтому мы решили взять четыре существующих бенчмарка от разных поставщиков (LlamaIndex, Extend, micro1 и Datalab), очистить их, стандартизировать оценку и сделать их максимально объективными.
Наш бенчмарк, OmniExtractBench, включает:
- 620 документов из четырех существующих бенчмарков от нескольких поставщиков. Это устраняет предвзятость;
- Оценщик, который является полностью детерминированным и объясняет каждое решение через «Вердикт» (Verdict) — атомарную, проверяемую единицу, которая точно указывает, было ли значение сопоставлено, прочитано неверно, пропущено, выдумано или сфабриковано, вместо того чтобы сводить все к одному непрозрачному баллу. Это делает его проверяемым;
- Четкие, последовательные и справедливые правила для сложных внутренних моментов, таких как оценка нулевых (null) значений по сравнению с пустыми полями. Это делает систему оценки прозрачной и понятной; и
- Документы, которые обычно вызывают сбои при извлечении: огромные таблицы с повторяющимися значениями, плотные скалярные схемы, научные статьи, кредитные договоры, резюме и финансовая отчетность. Это охватывает широкий спектр реальных сложных сценариев использования в различных отраслях.
Вот как показали себя несколько основных решений для извлечения данных при оценке по одной и той же методике на одном и том же корпусе документов:
Каждое среднее значение рассчитывается исходя из того, сколько документов поставщик действительно смог обработать — это столбец «покрытие» (coverage). Низкое покрытие — это ограничение поставщика: документ либо исчерпал лимит вывода, либо его схема была отклонена как слишком большая.
Мы продолжим улучшать инструментарий, проверяемость и справедливость этого бенчмарка. Мы будем рады услышать ваши мысли (особенно если вы не согласны). Код оценки находится на GitHub, а данные — на Hugging Face.
Данные
620 документов из 4 источников:
Ниже представлен разбор документов:
Оценщик
Сложности оценки
Проблема оценки извлечения данных заключается в неоднозначных адресах значений. Адрес — это путь к скалярному значению, по которому вы проходите через словарь, чтобы получить это значение. Например, единственный адрес следующего словаря {"a": {"b": "c"}} — это ("a", "b").
Во многих задачах извлечения данных нам нужно извлечь переменное количество JSON-объектов. Пользователь указывает это с помощью типа "array" в JSON-схеме. Это часто используется для больших таблиц — мы хотим извлечь много строк из таблицы, которые должны соответствовать определенной схеме.
Проблема здесь в том, что одна маленькая ошибка может стоить почти всей оценки таблицы при наивном подходе. Например, в таблице из 100 строк, если модель пропускает первую строку, каждая предсказанная строка будет смещена по позиции, что приведет к ужасному баллу, даже если модель фактически правильно обработала 99 из 100 строк.
Наш оценщик
Наш оценщик детерминирован и имеет простую конструкцию. Он состоит из трех компонентов:
- Нормализация документа;
- Нормализация скалярных значений; и
- Сопоставление листовых адресов: если неоднозначности нет, сопоставляем точно; если есть неоднозначность, используем венгерский алгоритм на основе содержимого (рекурсивно в случае вложенных массивов объектов).
- Если неоднозначности нет, сопоставляем точно; и
- Если есть неоднозначность, используем венгерский алгоритм на основе содержимого (рекурсивно в случае вложенных массивов объектов).
И он работает по следующим этапам:
- Нормализация документа;
- Преобразование предсказанного и эталонного JSON-словаря в плоский список адресов, сопоставленных с их скалярными значениями;
- Нормализация скалярных значений плоских адресов; и
- Для каждого встреченного массива применяется венгерский алгоритм (рекурсивно для вложенных массивов) на основе содержимого элементов массива для выравнивания неоднозначных предсказанных и эталонных адресов. Могут остаться несопоставленные предсказанные адреса (ложноположительные) и несопоставленные эталонные адреса (ложноотрицательные).
Для каждого документа этот процесс создает один Вердикт на каждый уникальный скалярный адрес, выровненный с помощью венгерского алгоритма при необходимости. Варианты:
- matched (совпало): было сопоставлено, и значения совпадают;
- misread (прочитано неверно): было сопоставлено, но значения не совпадают;
- unfound (не найдено): в эталоне есть адрес, а в предсказании нет;
- fabricated (сфабриковано): схема предлагала адрес, в эталоне его нет, но в предсказании он существует;
- invented_item (выдуманный элемент): скалярное предсказание элемента массива, которое ни с чем не сопоставилось; или
- invented_field (выдуманное поле): адрес, который схема никогда не объявляла.
Они являются взаимоисключающими в нашем коде, а также семантически. Единственное интересное решение, которое мы приняли: адрес попадает под категорию invented_item, если он находится внутри несопоставленного элемента (например, строки), даже если адрес был выдуманным полем внутри схемы этого элемента массива. Мы считаем, что это правильное решение: оно сигнализирует о том, что это было засчитано против модели за выдумывание элемента. Адреса вне массивов, которые схема не объявляла, считаются invented_field.
Как мы обрабатываем null-значения
Одной из проблем несогласованности в системах оценки является то, как они обрабатывают null. Сложность заключается в том, чтобы понять, когда модель что-то пропускает, а когда что-то утверждает. Это разница между утверждением, что ячейка в таблице не имеет значения, и тем, что ячейка содержит текст "n/a".
Мы обрабатываем null следующим образом (как для эталона, так и для предсказания):
- Мы делаем оба JSON плоскими, чтобы получить отображение адресов на их значения; и
- Мы проверяем значение и спрашиваем, означает ли оно отсутствие данных (пропуск) или нет (утверждение): "", None, "\t\n" — все превращаются в None; а "NA", "-", "--" — все остаются как есть.
- "", None, "\t\n" — все превращаются в None; и
- "NA", "-", "--" — все остаются как есть.
Для каждого адреса, который после этих шагов имеет значение None, мы удаляем весь адрес. Это означает, что пропуск адреса эквивалентен тому, что адрес указывает на None. Мы считаем, что это правильный подход, так как в противном случае метрику можно было бы «взломать» через ширину схемы.
«Взлом» выглядел бы так: добавление сотен необязательных полей в эталонную схему, которых на самом деле нет в документах бенчмарка. Модели тогда получали бы награду за нахождение «ничего», получая (по сути) бесплатные совпадения между None и None, что произвольно завышало бы баллы.
Метрики
Все метрические формулы основаны на количестве вердиктов, которое само по себе является количеством адресов после выравнивания. Количество всех вердиктов — это общее число.
Основные метрики:
- точность (accuracy) → |совпадения| / общее число;
- полнота (recall) → |совпадения| / |эталон|; и
- прецизионность (precision) → |совпадения| / |прогноз|.
Сила вердиктов
Вердикты позволяют нам обеспечить проверяемость результатов, а не просто кода, который к ним привел. Метрики декомпозируются на количество вердиктов, поэтому то, что вы видите в верхней части, можно проанализировать через иерархию абстракций, что способствует интерпретируемости.
Мы разрабатываем небольшой пользовательский интерфейс, который разбивает результаты по вердиктам и позволяет сопоставлять их с PDF-файлом и схемой. Вот предварительный просмотр:
Что дальше
Мы с нетерпением ждем отзывов от сообщества и продолжим совершенствовать бенчмарк, добавлять новые инструменты и развивать OmniExtractBench. В ближайшие недели мы подробнее расскажем о некоторых проблемах, которые мы видим в других бенчмарках. Мы также запустим инструменты, которые помогут вам оценивать результаты извлечения данных и повысить уверенность в них.
Как всегда, самый важный бенчмарк — это тот, который вы запускаете на своих собственных документах: протестируйте нашу «песочницу» на своих самых сложных файлах и сравните наши показатели со своими. Если у вас есть отзывы о бенчмарке, напишите нам на [email protected].