Если вы работаете в компании сферы AEC и хотите понять, что эти результаты значат для вашей практики, прочитайте нашу сопутствующую статью: Что AEC-Bench означает для AEC-компаний?
Архитектура, инжиниринг и строительство — это глобальная отрасль с объемом $13 триллионов. В то время как ИИ-агенты трансформировали процессы разработки программного обеспечения (агенты для написания кода сегодня помогают десяткам миллионов разработчиков), физический мир представляет собой следующий грандиозный рубеж для ИИ — рубеж, который еще только предстоит покорить. И дело не в недостатке амбиций, а в фундаментальном несоответствии между тем, как ИИ-агенты воспринимают информацию, и тем, как передается информация в физическом мире.
Сегодня мы выпускаем AEC-Bench — первый мультимодальный бенчмарк для оценки ИИ-агентов на реальных задачах в области архитектуры, инжиниринга и строительства. Включая 196 примеров задач в 9 семействах задач, AEC-Bench предоставляет первично разработанную для отрасли строгую систему оценки возможностей ИИ-агентов в процессах координации строительства. Наши результаты показывают, что именно предметно-ориентированная архитектура агентов, а не просто увеличение размера моделей, является ключом к раскрытию потенциала ИИ в строительной отрасли.
Мы выкладываем в открытый доступ датасет бенчмарка, агентный каркас и код оценки на github.com/nomic-ai/aec-bench по лицензии Apache 2.0 для полной воспроизводимости.
Строительная документация относится к числу наиболее информационно насыщенных артефактов, создаваемых в любой отрасли. Один комплект чертежей может содержать сотни страниц с плотно размещенными аннотациями, выносками, графическими линиями и перекрестными ссылками, интерпретация которых требует сложного визуального анализа. Это не изначально цифровые документы, подобные исходному коду, — это двухмерные проекции, экспортированные из программ 3D-моделирования, где смысл передается через структурированные визуальные и текстовые элементы, включая планы, детали, выноски, примечания и штампы.
Ошибки координации между архитекторами, инженерами и строительными командами являются главными причинами срыва сроков и перерасхода бюджета в строительных проектах. На этапах подготовки к строительству, проектирования, разработки инженерии и сдачи объекта многие задержки возникают из-за несоответствий, появляющихся при создании и редактировании комплектов чертежей и проектной документации. В ответ на это отраслевые команды полагаются на стандартизированные процессы проверки и координации, которые требуют глубокого профессионального опыта и мультимодального анализа — именно такой работы, с которой должны помогать ИИ-агенты, но которую они пока не способны выполнять надежно.
Стандартные агенты для написания кода — такие системы, как Claude Code и Codex, которые прекрасно справляются с навигацией по репозиториям исходного кода, — подходят к строительной документации с теми же стратегиями, которые они используют для кода: извлечение текста, поиск по ключевым словам и рендеринг изображений. Но строительная документация принципиально отличается. Инструменты извлечения текста, такие как pdftotext, сворачивают пространственную компоновку и геометрические связи в линейный текст, отбрасывая визуальную структуру, несущую критически важный смысл. Инструментам на основе компьютерного зрения не хватает точности, необходимой для надежного геометрического анализа. В результате возникает систематический сбой: агенты извлекают неполный или неверный контекст, что приводит к накоплению ошибок.
Наша оценка показывает, насколько укоренилось это поведение: среди всех оцениваемых моделей 77% траекторий агентов вызывали pdftotext в качестве основной стратегии извлечения информации, фактически обрабатывая сложные мультимодальные строительные документы как обычные текстовые файлы. Агенты на базе Codex полностью полагались на Bash (100% взаимодействий), выполняя каждое действие как команду оболочки. Этот инструментарий, ориентированный на написание кода, фундаментально не соответствует требованиям мультимодальной координации документации в сфере AEC.
AEC-Bench — это мультимодальный бенчмарк, основанный на реальных процессах координации строительства и разработанный в сотрудничестве с экспертами отрасли, включая практикующих архитекторов и инженеров. Мы отобрали 196 примеров задач в 9 семействах задач, распределенных по трем уровням сложности в зависимости от объема контекста документов, необходимого агенту для выполнения задачи координации:
Внутри страницы (Intra-Sheet) — задачи, решаемые в пределах одной страницы. Проверка соответствия выносок ссылаемым элементам, проверка названий деталей или анализ локального узла. Основное внимание уделяется пониманию связей между текстом и мультимодальными элементами чертежа на одной странице.
Внутри чертежа (Intra-Drawing) — задачи, требующие анализа нескольких листов в рамках одного комплекта чертежей. Проверка перекрестных ссылок, сравнение ведомости чертежей со штампами листов и отслеживание деталей по разным проекциям. Они требуют навигации между страницами и отслеживания связанной информации по всему комплекту.
Внутри проекта (Intra-Project) — задачи, охватывающие несколько документов: чертежи, спецификации и техническую документацию (submittals). Выявление противоречий между спецификациями и чертежами или оценка представленных материалов на соответствие требованиям. Они отражают реальную координацию на уровне проекта, когда релевантная информация распределена по различным документам.
Каждый пример задачи состоит из инструкции на естественном языке, изолированной среды выполнения (песочницы) с реальными строительными документами из проектов общественного сектора и автоматической системы проверки, оценивающей результат относительно эталонных данных, подготовленных профессиональными инженерами и архитекторами.
AEC Bench
Состав бенчмарка
196 примеров · 9 семейств задач · 3 уровня сложности
Одна страница
Несколько документов
Мы оценили производительность агентов на примере двух семейств универсальных агентных обвязок для программирования — Codex (GPT-5.2, GPT-5.4) и Claude Code (Opus 4.6, Sonnet 4.6) — в двух конфигурациях: H (базовая обвязка со стандартными инструментами) и H+N (базовая обвязка, дополненная инструментами Nomic, включая Nomic Parse и Nomic Embeddings). Мы также оценили полностью интегрированный Nomic Agent — наш предметно-ориентированный агентный каркас, созданный с нуля для процессов в строительной сфере.
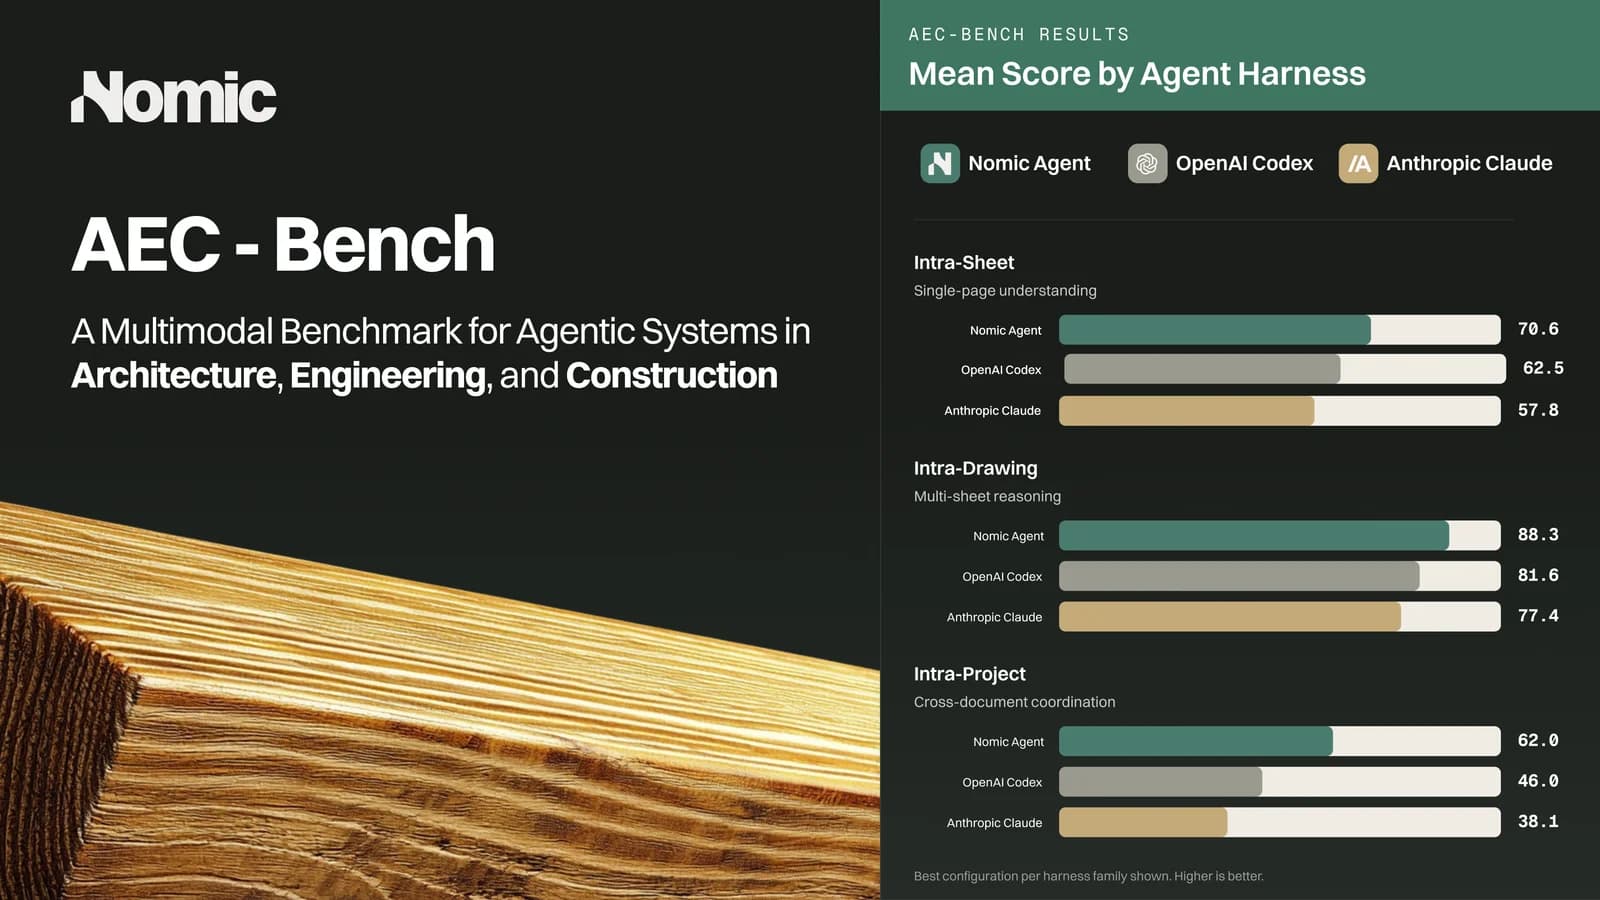
Nomic Agent достигает наивысшей общей производительности, закрепив за собой статус лидирующей агентной обвязки для задач в сфере AEC:
- Внутри страницы (Intra-Sheet): среднее вознаграждение 70.6 — на 8.1 пункта выше следующей лучшей конфигурации, что демонстрирует превосходное мультимодальное понимание одной страницы
- Внутри проекта (Intra-Project): среднее вознаграждение 62.0 — превосходит все остальные конфигурации в наиболее сложных задачах междокументной координации
- Внутри чертежа (Intra-Drawing): среднее вознаграждение 88.3 — лидирует среди всех конфигураций обвязки при анализе нескольких листов
AEC-Bench
Симуляции задач
v1.0 · 3 типа задач
Агент получает:
CivicCenter_ArchDrawings_PermitSet.pdf· 47 стр.
Ведомость чертежей Intra-Drawing
№ Описание
G-001
Общие примечания и сокращения
A-101
Генеральный план
A-201
План этажа — Уровень 1
A-202
План этажа — Уровень 2
A-301
Фасады
Штамп — Лист A-201
Проект
Civic Center Renovation
Portland, OR · Permit Set 2024-03
Название листа
План первого этажа
№ листа
A-201
Чертил
Дата
2024-03-15
Масштаб
1/8"=1'-0"
Задача: Найдите все записи в ведомости чертежей, которые не соответствуют фактическому штампу на этом листе.
Самый важный вывод AEC-Bench заключается в том, что именно поиск информации (retrieval) является основным узким местом для ИИ-агентов в сфере AEC. Агенты часто терпят неудачу еще до перехода к основному этапу логического анализа, так как не могут надежно найти нужный лист, деталь или документ. Как только удается извлечь правильный контекст, производительность существенно возрастает.
Дополнение базовых обвязок инструментами Nomic — структурированными представлениями чертежей, сгенерированными с помощью доменно-специфичных моделей, таких как Nomic Parse и Nomic Embeddings, — привело к значительному улучшению результатов в задачах, чувствительных к извлечению данных, во всех семействах базовых моделей:
- Детально-технический обзор: среднее улучшение по моделям на +32,2 пункта
- Синхронизация спецификаций и чертежей: среднее улучшение на +20,8 пункта
- Навигация по чертежам: среднее улучшение на +18,75 пункта, причем несколько моделей достигли идеального результата в 100%
Эти улучшения стабильно проявлялись во всех семействах базовых моделей — от GPT-5.4 до Sonnet 4.6, — что доказывает: структурированное, доменно-специфичное представление документов одинаково повышает производительность агентов независимо от используемой модели.
Тем не менее, задачи, требующие точной визуально-пространственной привязки — такие как точность выносок на заметках и отслеживание перекрестных ссылок, — показали, что одного лишь синтаксического анализа документов недостаточно. Эти задачи требуют отслеживания выносных линий и интерпретации геометрических взаимосвязей чисто визуальным путем, что остается конкретной проблемой для текущих обвязок базовых моделей. Этот вывод указывает на необходимость более глубоких возможностей визуальной привязки в агентных системах следующего поколения.
Мы считаем, что индустрия AEC заслуживает строгих открытых бенчмарков для стимулирования прогресса в внедрении ИИ. По мере эволюции агентных бенчмарков включение реалистичных структур документов и рабочих процессов будет иметь решающее значение для понимания поведения агентов в прикладных условиях. AEC-Bench — это наш вклад в достижение этой цели.
Полный бенчмарк, обвязки агентов и код для оценки доступны по адресу под лицензией Apache 2.0. Мы призываем исследователей и практикующих специалистов развивать эту работу и расширять границы того, чего могут достичь агенты ИИ в созданной человеком среде.
В дальнейшей работе бенчмарк будет расширен за счет включения более крупных наборов чертежей, новых дисциплин AEC и дополнительных групп задач. Мы разрабатываем улучшенные верификаторы, которые оценивают обоснованность доказательств и этапы рассуждений, а также проектируем агентские системы, созданные специально для навигации по документам — системы, которые итеративно исследуют наборы чертежей, поддерживают пространственную память на листах и извлекают области доказательств перед проведением рассуждений.
Чтобы узнать больше о том, как Nomic создает платформу ИИ для созданной человеком среды, посетите нашу платформу или закажите демо.
Харш Манкодия, Чейз Галлик, Теодорос Галанос (Aurecon), Андрий Муляр Nomic